博客

  • Design and implementation of NDN-based Ethereum blockchain

    Design and implementation of NDN-based Ethereum blockchain

    基于NDN的以太坊区块链的设计与实现

    作者:Quang Tung Thai, Namseok Ko, Sung Hyuk Byun, Sun-Me Kim

    论文摘要原文:

    Blockchain technology allows public parties to agree on a common state without relying on a central authority. Despite it brings many innovative use cases, the technology is still in its early stage that needs improving on many aspects. One of the issues is to deliver blockchain data more efficiently. Named Data Networking (NDN), a new network paradigm, is designed to make content distribution with ease by enabling in-network caching and built-in multicasting, which blockchain technologies can take advantage. Moreover, blockchain may contribute to extending NDN application ecosystems including decentralized applications. Therefore, it is instrumental to have a working blockchain system that runs on NDN platform to supports its research and development.

    In this work, we design and implement an NDN-based Ethereum blockchain platform. We propose new protocols for propagating blockchain data making full use of NDN features for the delivery of transactions and blocks. Our experiments show that the distribution of blockchain data in NDN is more efficient than that of IP network. The latency of block delivery is also reduced, which in turn supports tuning blockchain parameter for better security. Our developed blockchain client is freely distributed as an open-source project. We hope that it can provide a platform to foster blockchain research on NDN in the future.

    论文摘要中文:

    区块链技术允许公共各方在不依赖中央权威的情况下就共同状态达成一致。尽管它带来了许多创新的用例,但该技术仍处于早期阶段,需要在许多方面进行改进。其中一个问题是如何更高效地交付区块链数据。命名数据网络(Named Data Networking,NDN)是一种新的网络模式,它通过支持网内缓存和内置多播来实现内容的分发,区块链技术可以充分利用这一点。此外,区块链可能有助于扩展NDN应用程序生态系统,包括分散式应用程序。因此,拥有一个在NDN平台上运行的工作区块链系统来支持其研究和开发是非常重要的。

    在本文中,我们设计并实现了一个基于NDN的以太坊区块链平台。我们提出了新的协议来传播区块链数据,充分利用NDN的特性来传递事务和块。理论分析和实验结果表明,区块链数据在NDN网络中的分发比IP网络中的分发效率更高.区块交付的延迟也被降低,这反过来又支持调整区块链参数以获得更好的安全性。我们开发的区块链客户端作为开源项目免费发布,希望它能为未来NDN的区块链研究提供一个平台。

    Design and implementation of NDN-based Ethereum blockchain插图

    研究问题、关键问题: 本文主要研究如何将区块链技术应用于 NDN 网络,以提高区块链数据传输的效率。其中关键问题为:

    • 区块链数据传输效率:传统区块链系统数据传输效率低下,如何利用 NDN 的特性(如命名、缓存、多播)进行区块链数据传输?如何在NDN中实现基于Kademlia的对等体发现,以及节点如何建立和管理用于区块链数据传递的对等体连接列表?
    • NDN 网络的安全性问题:NDN网络面临缓存污染攻击等安全问题,如何在利用 NDN 特性的同时,保证区块链系统的安全性?
    • 区块链系统的可扩展性:NDN 网络的可扩展性是一个挑战,如何设计区块链系统,使其能够在 NDN 网络上高效运行,并支持大规模节点?

    研究动机、研究意义:

    1.研究动机:

    (1)区块链数据传输效率低下: 传统区块链系统使用 P2P 协议进行数据传输,效率低下且容易受到攻击。
    (2)NDN 的优势: NDN 是一种信息中心网络范式,具有内置缓存和多播功能,可以高效地传输数据。
    (3)区块链与 NDN 的融合潜力: 将区块链技术应用于 NDN 网络,可以利用 NDN 的优势来提高区块链数据传输效率,同时保持系统的可扩展性和安全性。

    2.研究意义:

    (1)提高区块链数据传输效率: 利用 NDN 的缓存和多播功能,可以显著降低区块链数据传输的延迟和带宽消耗。
    (2)推动区块链与 NDN 的融合: 本研究可以为区块链与 NDN 的融合提供参考,为未来构建更加高效、安全的网络基础设施奠定基础。

    研究内容(算法、方法、技术、模型):本文主要研究如何设计和实现一个基于 NDN 平台的以太坊区块链客户端,其研究内容主要包括以下几个方面:

    1. 数据传输协议设计:
    2. 公告-拉取 (Announce-Pull) 机制: 利用 P2P 协议进行数据公告,利用 NDN 的拉取机制进行数据检索,实现高效的区块链数据传输。
    Design and implementation of NDN-based Ethereum blockchain插图1
    • 数据命名: 设计了 NDN 数据包的命名方案,包括公前缀和私前缀,以支持数据检索和缓存。
    • 协议消息: 定义了公告消息、数据请求消息和数据段消息,用于实现区块链数据的传输和验证。
    • 缓存投毒攻击防御: 设计了针对缓存投毒攻击的防御机制,确保数据传输的安全性。
    •  ndn-geth 客户端实现:
    • 基于 geth 的改进: 使用 open-source 的 geth Ethereum 客户端作为代码基础,并进行修改以适应 NDN 环境。
    • P2P 层改进: 使用 Kademlia DHT 协议实现基于 NDN 的 P2P 节点发现和连接管理。
    • 数据传播模块改进: 实现了基于公告-拉取机制的交易和块传播算法。
    • 其他模块: 保留了 Ethereum 客户端中其他模块的实现,例如数据存储、共识算法等。
    Design and implementation of NDN-based Ethereum blockchain插图2
    • 性能评估:
    • 仿真实验: 在 mininet 仿真环境中,比较了基于 NDN 的区块链系统和基于 IP 的区块链系统的数据传输效率和块传播延迟。
    • 实验结果:基于 NDN 的区块链系统在数据传输效率和块传播延迟方面均优于基于 IP 的区块链系统。

    研究结论、主要贡献:

    1. 研究结论:
    2. 基于NDN的区块链系统可以有效提高区块链数据传输效率,并降低块传播延迟。
    3. 本文提出的公告-拉取机制,可以有效地利用 NDN 的缓存和多播功能,实现高效的区块链数据传输。
    4. 基于NDN的区块链系统与以太坊区块链完全兼容,可以支持现有的 Ethereum 的区块链应用。
    5. 主要贡献:
    6. 设计了一种新的基于 NDN 的区块链数据传输协议,并实现了该协议。
    7. 实现了一个基于 NDN 的以太坊区块链客户端,并将其与以太坊区块链完全兼容。
    8. 通过仿真实验验证了基于 NDN 的区块链系统在数据传输效率和块传播延迟方面的优势。
    9. 为区块链技术在 NDN 网络上的研究和应用提供了平台。

    创新点、创新性:

    • 基于NDN的区块链系统及数据传输协议设计: 利用了 NDN 的缓存和多播功能来提高区块链数据传输效率,并设计了新的数据传输协议,包括数据命名方案、协议消息格式和数据传输流程,以支持高效的以太坊区块链数据传输。
    • 公告-拉取机制: 本文提出的公告-拉取机制可以有效利用 NDN 的缓存和多播功能,实现高效的区块链数据传输,并解决了缓存投毒攻击问题。
    • P2P 层改进: 由于 ICN 架构自带内容分发优化特性,有人可能会考虑完全摒弃 P2P 层,直接利用 NDN 的广播和多播功能进行数据传输。本文选择保留 P2P 层,并进行改进以适应 NDN 环境,实现了节点发现和连接管理。
    • 性能评估: 通过仿真实验验证了基于 NDN 的区块链系统在数据传输效率和块传播延迟方面的优势,为基于 NDN 的区块链系统提供了理论依据。

    技术难点:

    1.NDN 网络环境适应性:

    (1)NDN 路由表可扩展性: NDN 网络的 FIB 表可以存储大量路由信息,但其可扩展性是一个挑战,需要设计有效的路由策略和路由协议来避免路由表溢出。
    (2)NDN 数据缓存: NDN 网络中数据缓存的安全性需要考虑,需要设计有效的缓存更新机制和缓存验证机制来防止缓存投毒攻击。
    (3)NDN 多播: NDN 网络的多播功能需要有效利用,需要设计有效的多播路由策略和数据分发机制来提高数据传输效率。

    2.区块链与 NDN 的融合:

    (1)P2P 层改进: 在 NDN 网络中保留 P2P 协议并进行改进,需要解决节点发现、连接管理和数据传输等问题。
    (2)数据命名: 设计 NDN 数据包的命名方案,需要考虑数据的唯一性、可路由性和可缓存性等问题。
    (3)数据传输协议: 设计新的数据传输协议,需要考虑数据的安全性、完整性和效率等问题。

    3.缓存投毒攻击防御:

    (1)缓存验证: 需要设计有效的缓存验证机制来防止缓存投毒攻击,例如使用数字签名等技术来验证数据的真实性。
    (2)缓存更新: 需要设计有效的缓存更新机制来保证缓存数据的最新性,例如使用时间戳等技术来标记缓存数据的有效期。

    4.性能优化:

    (1)NFD 性能: NFD 的性能会影响区块链数据传输的效率,需要优化 NFD 的数据包处理性能来提高数据传输效率。
    (2)网络拓扑: 网络拓扑结构会影响区块链数据传输的延迟和带宽消耗,需要选择合适的网络拓扑结构来提高数据传输效率。

    进一步研究思路 (Future Work):

    1. 性能优化:
    2. NFD 性能优化: 进一步优化 NFD 的数据包处理性能,例如使用硬件加速技术、并行处理等技术来提高 NFD 的处理效率。
    3. 网络拓扑优化: 研究不同网络拓扑结构对区块链数据传输效率的影响,并设计合适的网络拓扑结构来提高数据传输效率。
    4. 数据传输协议优化: 优化数据传输协议,例如改进数据命名方案、改进数据传输流程等,进一步提高数据传输效率。
    5. 安全性增强:
    6. 拜占庭容错: 研究在 NDN 网络中实现拜占庭容错机制,例如使用 NDN 安全路由协议、使用基于区块链的拜占庭容错协议等。
    7. 数据完整性保护: 研究数据完整性保护机制,例如使用数字签名、使用 Merkle 树等技术来保证数据的完整性。
    8. 功能扩展:
    9. 跨链交互: 研究不同区块链系统之间的跨链交互机制,例如实现基于 NDN 的跨链通信协议等。
    10. 数据市场: 研究基于区块链的 NDN 数据市场,例如实现数据定价机制、数据交易机制等。

    个人总结:

    本文提出了一种基于 NDN 的 Ethereum 区块链平台设计方案,利用 NDN 的缓存和多播功能优化了区块链数据传输效率,并将 P2P 层针对NDN网络进行改进,实现了数据发布和高效检索。实验结果表明,该系统在数据传输效率、安全性和可扩展性方面均优于传统 IP 网络的区块链系统。

  • 北京大学 雷凯《区块链导论》 —郑纬民院士、李晓明教授作序

    国务院发布的《“十四五”数字经济发展规划的通知》明确指出,到2025年实现我国数字经济竞争力和影响力的稳步提升。23年7月新出版的《区块链导论》(作者:北京大学 雷凯;ISBN:978-7-121-45433-2)一书全面介绍了区块链的基础知识,包括区块链概述、区块链密码学、P2P网络、共识算法、智能合约、区块链经典应用、区块链技术生态等。与同类书籍相比,新书增加涉及了前沿知识技术的介绍,包括区块链与元宇宙、Web3.0、大模型等。例如区块链在2022北京冬奥会中的应用、区块链与以ChatGPT为代表的通用人工智能(AIGC)结合点,尤其如何理解中国特色的区块链技术发展路径等。书籍定稿之时正值党的二十大胜利召开之后的全国两会召开之际,该书既可以作为高等院校区块链、计算机、金融科技等专业相关课程的教材,又可以作为区块链、金融科技等领域从业人员的参考用书。

    中国工程院院士、前中国计算机学会CCF理事长、清华大学计算机系郑纬民教授,大湾区大学(筹)教学负责人、北京大学瑞声慕课讲席教授、CCF创建60周年杰出贡献奖获得者李晓明,全国区块链和分布式记账技术标准化技术委员会副秘书长、浙江大学区块链研究中心常务副主任蔡亮共同作序。

    北京大学 雷凯《区块链导论》 —郑纬民院士、李晓明教授作序插图

    郑纬民院士表示,《区块链导论》这本书一方面授人以鱼,为广大爱好者脉络分明地梳理区块链庞大的知识体系,以广泛的应用案例阐述区块链技术内容;另一方面授人以渔,通过鞭辟入里的案例分析、深入浅出的技术讲解,搭建理论与实践之间的桥梁,激励广大爱好者在区块链领域勇于探索真理。主要内容源自北京大学深圳研究生院深圳市内容中心网络与区块链重点实验室(ICNLAB)的老师和同学们近年来长期在新型网络体系架构、区块链架构等方面的研究成果,以及自主提出的智能生态网络IEN新型链网架构。在经济全球化、一体化、我国数字经济自主可控发展迅速的背景下,希望本书的出版能在教育实践中将“科教兴国”战略走深走实,并为培养具有创新意识、跨学科交叉、面向前瞻互联网3.0技术生态的高质量复合型人才提供些有益的启迪。

    李晓明老师指出,这是一本介绍区块链技术的入门书,适合对计算机技术有基本了解但对区块链不太熟悉的读者。本书不仅介绍了区块链的技术原理和应用场景,还反映了作者对区块链的深入思考和见解,如去中心化的意义和局限性,同时也提出了一些思考题,帮助读者理解和掌握区块链的核心概念和特点。

    蔡亮老师提到,我国将区块链作为自主创新的重点,推动关键技术突破和产业创新发展,拓展区块链在金融、政务、工业等领域的应用场景,抢占科技革命的制高点。雷凯老师团队编写的《区块链导论》是一本理论与实践相结合的好书,全面介绍了区块链的基本原理、关键技术、应用成果和前沿趋势,适合科技工作者和相关领域从业人员阅读。

    《区块链导论》作者雷凯系北京大学深圳研究生院深圳市内容中心网络与区块链重点实验室(ICNLab)主任,国家科技部重点研发区块链专项首席科学家,中国科学技术发展战略研究院金融科技咨询专家;中国计算机学会(CCF)杰出会员、区块链专委会常务委员;广东省计算机学会区块链专委会副主任、“科创中国”未来网络专业科技服务团特聘专家。

    北京大学 雷凯《区块链导论》 —郑纬民院士、李晓明教授作序插图1

    2005年到2011年期间,雷凯一直在北京大学深圳互联网中心(CIRE)研发名为“天网Maze”的网络文件系统。 Maze曾经是教育网中最大、最早的P2P文件存储共享系统(类似Napster、迅雷),累计注册用户达到850万。研究过程中曾分享随笔“区块链:阿凡达文明的缔造之魂,信息中心网络:潘多拉世界砥砺之基”;在CCF区块链专委杭州会议报告——“块游记:区块链如何与未来网络基础设施结合”。2010年开始,雷凯在李晓明老师的启迪下,开始关注NDN新型网络体系架构的研究,进一步深刻认识到近半个世纪以IP为主导的网络体系结构面对当代极大丰富的互联网上层应用在底层基础设施层面上的“不堪重负”,从而坚定了从基础网络层面结合区块链、人工智能网络控制领域技术研究热情,2018年在IEEE HotICN国际会议上自主提出了“智能生态网络(Intelligent Eco Networking,简称IEN)” 。

    2023年7月30日

    延伸阅读:

    1. 《区块链风险更复杂多样,需要建立标准与监管共识》,2017年1月,胡润金融科技大会,深圳
    2. 《区块链:阿凡达文明的缔造之魂,信息中心网络:潘多拉世界砥砺之基》,2018年3月,CCFYOCSEF,深圳
    3. 《IENII:知识驱动的边缘智能生态网络设想及初探》,2019年5月,南京未来网络大会
    4. 《智能生态网络:知识驱动的未来价值互联网基础设施》,应用科学学报,2020年1月
    5. 《面向边缘人工智能计算的区块链技术综述》,应用科学学报,2020年1月

    视频纵览:

    1. 《块游记:区块链如何与NDN等未来网络基础设施结合》2018年11月,CCF区块链大会,杭州
    2. 《IEN III:5G边缘算力网络》,2020年6月,南京未来网络大会
    3. 《IEN 3.X:区块链与命名机制在未来网络体系结构中的先进原理》,2021年6月,南京未来网络大会
    4. 《IEN 2021:基于价值数据NFT的开放可信数字底座》,2021年11月,4th Hot ICN,南京
    5. 《IEN 2022——面向Web3.0的内容中心链网底层基础设施》2022年11月,5thHot ICN,广州
  • 会议征稿|新型网络体系与技术国际学术会议

    会议征稿|新型网络体系与技术国际学术会议

    原文链接:http://icenat.pcl.ac.cn/

    会议征稿|新型网络体系与技术国际学术会议插图

    ICENAT新型网络体系与技术国际学术会议将针对新型网络领域的最新成果,围绕新型网络架构、网络前沿技术、行业网络应用等主题,邀请国内外专家交流最新研究进展和应用创新经验,共同探索新型网络的发展趋势和热点方向,加强新型网络领域学术界、产业界合作交流,提升我国新型网络技术的核心竞争力。2022年新型网络体系与技术国际学术会议(ICENAT 2022) 将于10月15-17日在中国深圳召开。

    会议征稿|新型网络体系与技术国际学术会议插图1

    大会主席

    高文 院士(鹏城实验室)

    方滨兴 院士(鹏城实验室)

    大会联合主席

    陆建华 院士(国家自然基金委、清华大学)

    张峰 电子学会理事长

    张延川 通信学会秘书长

    执行主席

    张宏科 院士(北京交通大学、鹏城实验室)

    指导委员会主席

    邬江兴 院士(战略支援部队信息工程大学)

    沈学民 院士(加拿大滑铁卢大学,中国工程院外籍院士)

    Nei Kato 院士(日本Tohoku University,日本工程院院士)

    技术委员会主席

    张伟哲 教授(鹏城实验室)

    徐恪 教授(清华大学)

    谢高岗 教授(中科院网络中心)

    冯志勇 教授(北京邮电大学)

    董平 教授(北京交通大学)

    会议秘书长

    陈佳 教授(北京交通大学)

    程序委员会主席

    郜帅 教授(北京交通大学)

    许长桥 教授(北京邮电大学)

    罗洪斌 教授(北京航空航天大学)

    虞红芳 教授(电子科技大学)

    陈佳媛 博士(中国移动研究院, 网络与IT技术研究所)

    会议征稿|新型网络体系与技术国际学术会议插图2
    邬江兴

    中国工程院院士,通信与信息系统、计算机与网络技术专家,曾担任“九五”、“十五”国家863计划通信技术主题专家组副组长,“十一五”国家863计划信息领域专家组副组长、国家移动通信重大专项论证委员会主任、国家三网融合专家组第一副组长等职务。因HJD04机的技术和产业贡献,获得1994年何梁何利科技进步奖和1995年度国家科技进步一等奖。因主持研制成功“高性能宽、窄带混合数字交换系统”,产生25亿多元人民币直接经济效益,获1998年度国家科技进步二等奖。因领衔完成863计划“中国高速信息示范网”重大专项,带动我国互联网核心装备技术和产业跨越式发展,获2002年度国家科技进步二等奖。因主持完成863计划“高性能宽带信息网”专项,使我国宽带信息网络关键技术和相关产业步入世界先进行列,获2007年度国家科技进步二等奖。因在国家“531”重大工程中的特殊贡献,获2009年度国家科技进步一等奖。因在国家“517”重大工程中的特殊贡献,获2013年度国家科技进步一等奖。2013年因主持863计划重点项目“新概念高效能计算机体系结构及系统研究开发”,提出基于动态变结构的拟态计算架构和拟态防御理论框架,成功研制出世界上首台拟态计算机,入选由两院院士评选的“2013年中国十大科技进展”。2015年因在信息通信领域做出的一系列突出贡献和成就,获得何梁何利科学技术成就奖。

    会议征稿|新型网络体系与技术国际学术会议插图3
    沈学民

    Xuemin (Sherman) Shen (M’97–SM’02–F’09) received the Ph.D. degree in electrical engineering from Rutgers University, New Brunswick, NJ, USA, in 1990. He is a University Professor with the Department of Electrical and Computer Engineering, University of Waterloo, Canada. His research focuses on network resource management, wireless network security, Internet of Things, 5G and beyond, and vehicular networks. Dr. Shen is a registered Professional Engineer of Ontario, Canada, a Canadian Academy of Engineering Fellow, a Royal Society of Canada Fellow, a Chinese Academy of Engineering Foreign Member, and a Distinguished Lecturer of the IEEE Vehicular Technology Society and Communications Society.Dr. Shen served as the Technical Program Committee Chair/Co-Chair for IEEE Globecom’16, IEEE Infocom’14, IEEE VTC’10 Fall, IEEE Globecom’07, and the Chair for the IEEE ComSoc Technical Committee on Wireless Communications. Dr. Shen is the President of the IEEE ComSoc. He was the Vice President for Technical & Educational Activities, Vice President for Publications, Member-at-Large on the Board of Governors, Chair of the Distinguished Lecturer Selection Committee, and Member of IEEE Fellow Selection Committee of the ComSoc. Dr. Shen served as the Editor-in-Chief of the IEEE IoT JOURNAL, IEEE Network, and IET Communications.

    会议征稿|新型网络体系与技术国际学术会议插图4
    Nei Kato

    Nei Kato is a full professor and the Dean with Graduate School of Information Sciences, Tohoku University. He has researched on computer networking, wireless mobile communications, satellite communications, ad hoc & sensor & mesh networks, UAV networks, smart grid, AI, IoT, Big Data, and pattern recognition. He has published more than 500 papers in prestigious peer-reviewed journals and conferences. He is the Director of Magazine of IEEE Communications Society. He served as the Vice-President (Member & Global Activities) of IEEE Communications Society (2018-2021), the Editor-in-Chief of IEEE Network Magazine(2015-2017), and the Editor-in-Chief of IEEE Transactions on Vehicular Technology (2017-2021). He is a Distinguished Lecturer of IEEE Communications Society and Vehicular Technology Society, a Fellow of the Engineering Academy of Japan, a Fellow of IEEE, and a Fellow of IEICE.

    更多特邀报告和中国工程院院士等嘉宾待确定。

    会议征稿具体方向包括但不限于:

    专题一: 新型网络及技术

        新型网络体系架构

        新型路由和交换技术

        新型网络寻址和命名技术

        绿色网络技术

        软件定义网络(SDN)、网络功能虚拟化(NFV)、信息中心网络(ICN)、算力网络(CFN)、意图网络(IBN)

    专题二: 网络智慧化理论与技术

        人工智能在新型网络中的应用

        网络孪生、元宇宙

        区块链及应用

        网络感知与网络测量

        路由算法、流量调度、拥塞控制

        智慧化数据平面设计

        网络资源编排和管理

        自动化管理策略

        意图驱动下的智慧管控

        网络应用和内容分发

    专题三: 异构网络与网络融合

        异构网络融合理论与技术

        空天地海一体化网络

        网络、存储和计算融合

        多域网络融合

        有线无线网络融合

        云网融合、算网融合

        云网边端一体化

    专题四: 网络服务质量保障与安全

        确定性网络理论与技术

        时延敏感网络理论与技术

        网络故障检测、定位与恢复

        网络弹性设计

        网络安全、攻击检测与防御技术

        网络存储安全和隐私

    专题五: 行业网络应用

        新型网络的大规模实验平台

        新型网络的行业应用设计和实验

        实验平台的设计、实现和部署design, implementation and deployment of testbed

    专题六: 信息中心网络

        ICN架构设计以及演进

        ICN中的路由、转发以及缓存

        ICN安全解决方案,包括隐私、信任管理、接入控制以及密钥管理

        ICN的移动性以及受限环境解决方案

        ICN中的网络管理,例如检测和错误检测

        ICN在解决现有问题方面的设计、实现以及评价

    出版确认:会议论文集由SPRINGER出版社出版,推荐EI等数据库检索.

    重要日期
    会议投稿截止日期:2022年6月30日
    录用通知日期:2022年8月30日
    终稿上传截止日期:2022年9月15日
    会议日期:2022年10月15-17日

    会议投稿投稿系统准备就绪。

    扫描二维码投稿或者访问以下链接投稿

    https://easychair.org/my/conference?conf=icenat2022

    更多投稿信息,请访问官网投稿页面

    http://icenat.pcl.ac.cn/

    鹏城实验室介绍鹏城实验室是中央批准成立的突破型、引领型、平台型一体化的网络通信领域新型科研机构,作为国家战略科技力量的重要组成部分,聚焦宽带通信和新型网络等国家重大战略任务以及粤港澳大湾区、中国特色社会主义先行示范区建设的长远目标与重大需求,按照“四个面向”的要求,以网络通信、网络空间和网络智能为主要研究方向,开展领域内战略性、前瞻性、基础性重大科学问题和关键核心技术研究。

    鹏城实验室坚持以重大任务攻关和重大科技基础设施与平台建设为牵引,以科技创新和体制机制创新为主线,深入探索社会主义市场经济条件下关键核心技术攻关新型举国体制,集聚了包括31位院士、200位国际会士、国家杰青等高端人才在内的3400余位各类人才,建成了以“鹏城云脑”为代表的若干重大科技基础设施与平台,发布了“丝路”多语言机器翻译平台、“鹏程.盘古”中文预训练语言模型等一系列重大应用。

    联系我们

    地址:鹏城实验室广东省深圳市南山区科兴街2号

    联系方式:

    会议秘书长:陈佳 教授

    +86-13521084132

    邮箱地址:icenat2022@163.com

  • 2019第二届IEEE信息中心未来网络国际学术会议(HotICN)在重庆邮电大学召开

    2019第二届IEEE信息中心未来网络国际学术会议(HotICN)在重庆邮电大学召开

    2019年12月14日至15日,由重庆市科学技术协会主办,IEEE通信协会技术支持,重庆邮电大学和重庆市电子学会承办的2019第二届IEEE信息中心未来网络国际学术会议(IEEE HotICN 2019)在学校逸夫楼召开。加州大学洛杉矶分校(UCLA)张丽霞教授,德国艾姆登/里尔应用科学大学Dirk Kutscher教授、清华大学刘斌教授、东南大学郑军教授和中电科创新中心GQ Wang,HotICN发起人、北京大学深圳研究生院雷凯副教授以及来自中国、美国、德国、韩国、法国和加拿大等国的100余位专家学者出席了会议。

    副校长吕翊代表学校致辞,对各位专家学者来校出席大会表示热烈欢迎。他介绍了学校的学科特色及国内外学术合作交流情况,并就学校在加强电子信息领域的传统特色及大力发展前沿技术,不断深化产学研合作方面进行了重点介绍。

    重庆市科协党组成员、副主席李彦讲话指出,当前以人工智能、量子信息、移动通信、物联网、区块链为代表的新一代信息技术加速突破,信息中心网络技术以互联网的主要需求为导向,以信息为中心构建网络体系架构,在内容高效分发、移动性支持、约束场景的应用等方面具有优势。但在系统拓展性、应用安全性等方面尚未成熟,技术的国际标准化也尚未构建。他希望基于HotICN大会平台,各位专家学者更多地集智谋划、跨界协同、开放合作。

    会议期间,加州大学洛杉矶分校(UCLA)张丽霞教授作题为“互联网去中心化之路”的大会报告;来自德国艾姆登/里尔应用科学大学Dirk Kutscher教授就信息中心网络发展的挑战作大会报告;北京交通大学张宏科教授作题为“未来互联网的架构和系统”的报告;世界银行组织张志军博士作关于标识网络与区块链方面的主题报告。

    整个会议安排有四个ICN分论坛和一个区块链分论坛以及ICN发展论坛。同时会议还采用了先进的视频直播系统,更加方便了海内外专家学者与现场来宾对话交流。为鼓励广大年轻学者积极参与其中,大会设置了“best paper”以及“student travel grant”等相关奖项,对调动学生的积极性起到了良好作用。

    本届会议为ICN/NDN和区块链领域的广大学者和研究人员提供了一个高层次的学术交流平台,并借此平台促进了该领域的学术交流与合作。

    2019第二届IEEE信息中心未来网络国际学术会议(HotICN)在重庆邮电大学召开插图

    2019第二届IEEE信息中心未来网络国际学术会议在我校召开(记者 胡镇 摄)

    重庆市科协党组成员,李彦副主席讲话.jpg

    重庆市科协党组成员、副主席李彦讲话(记者 冯正则 摄)

    2019第二届IEEE信息中心未来网络国际学术会议(HotICN)在重庆邮电大学召开插图2

    加州大学洛杉矶分校(UCLA)张丽霞教授作(记者 刘铭乐 摄)

    2019第二届IEEE信息中心未来网络国际学术会议(HotICN)在重庆邮电大学召开插图3

    德国艾姆登/里尔应用科学大学Dirk Kutscher教授作报告(记者 刘馨灿 摄)

    北京交通大学张宏科教授作大会报告.jpg

    北京交通大学张宏科教授作报告(记者 马云舒 摄)

    2019第二届IEEE信息中心未来网络国际学术会议(HotICN)在重庆邮电大学召开插图5

    世界银行组织张志军博士作报告(记者 崔议心 摄)

    大会合影.jpg

    与会专家学者合影(电信研究院 供图)

    http://xcb.cqupt.edu.cn/info/1025/5481.htm

  • Multi2: Hierarchical Multi-Agent Decision-Making with LLM-Based Agents in Interactive Environments

    Multi2: Hierarchical Multi-Agent Decision-Making with LLM-Based Agents in Interactive Environments

    1. 摘要(Abstract)

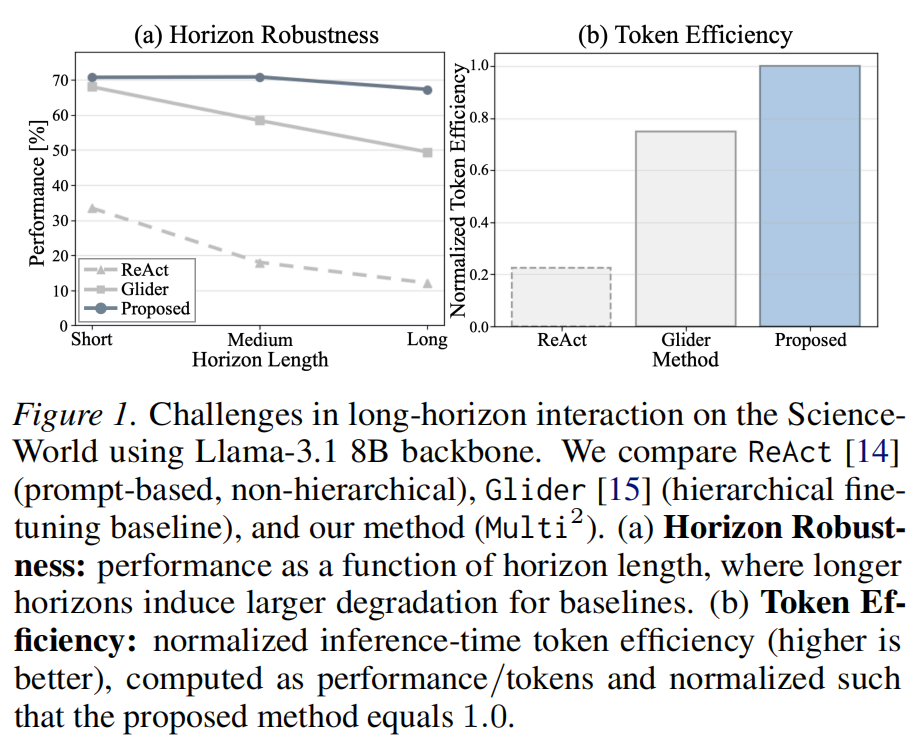
    本文研究的是长程交互环境中大模型智能体的决策稳定性问题。现有 LLM-based agents 已经具备较强的上下文理解和推理能力,但在多轮交互任务中仍然容易出现目标漂移。也就是说,模型一开始能够理解任务目标,但随着交互轮次增加,计划和动作会逐渐偏离原始意图,最终导致无效动作、循环行为或任务失败。针对这一问题,论文提出了 Multi²,一个层级化多智能体决策框架,用于提升智能体在长程交互环境中的稳定性、鲁棒性和 token 使用效率。

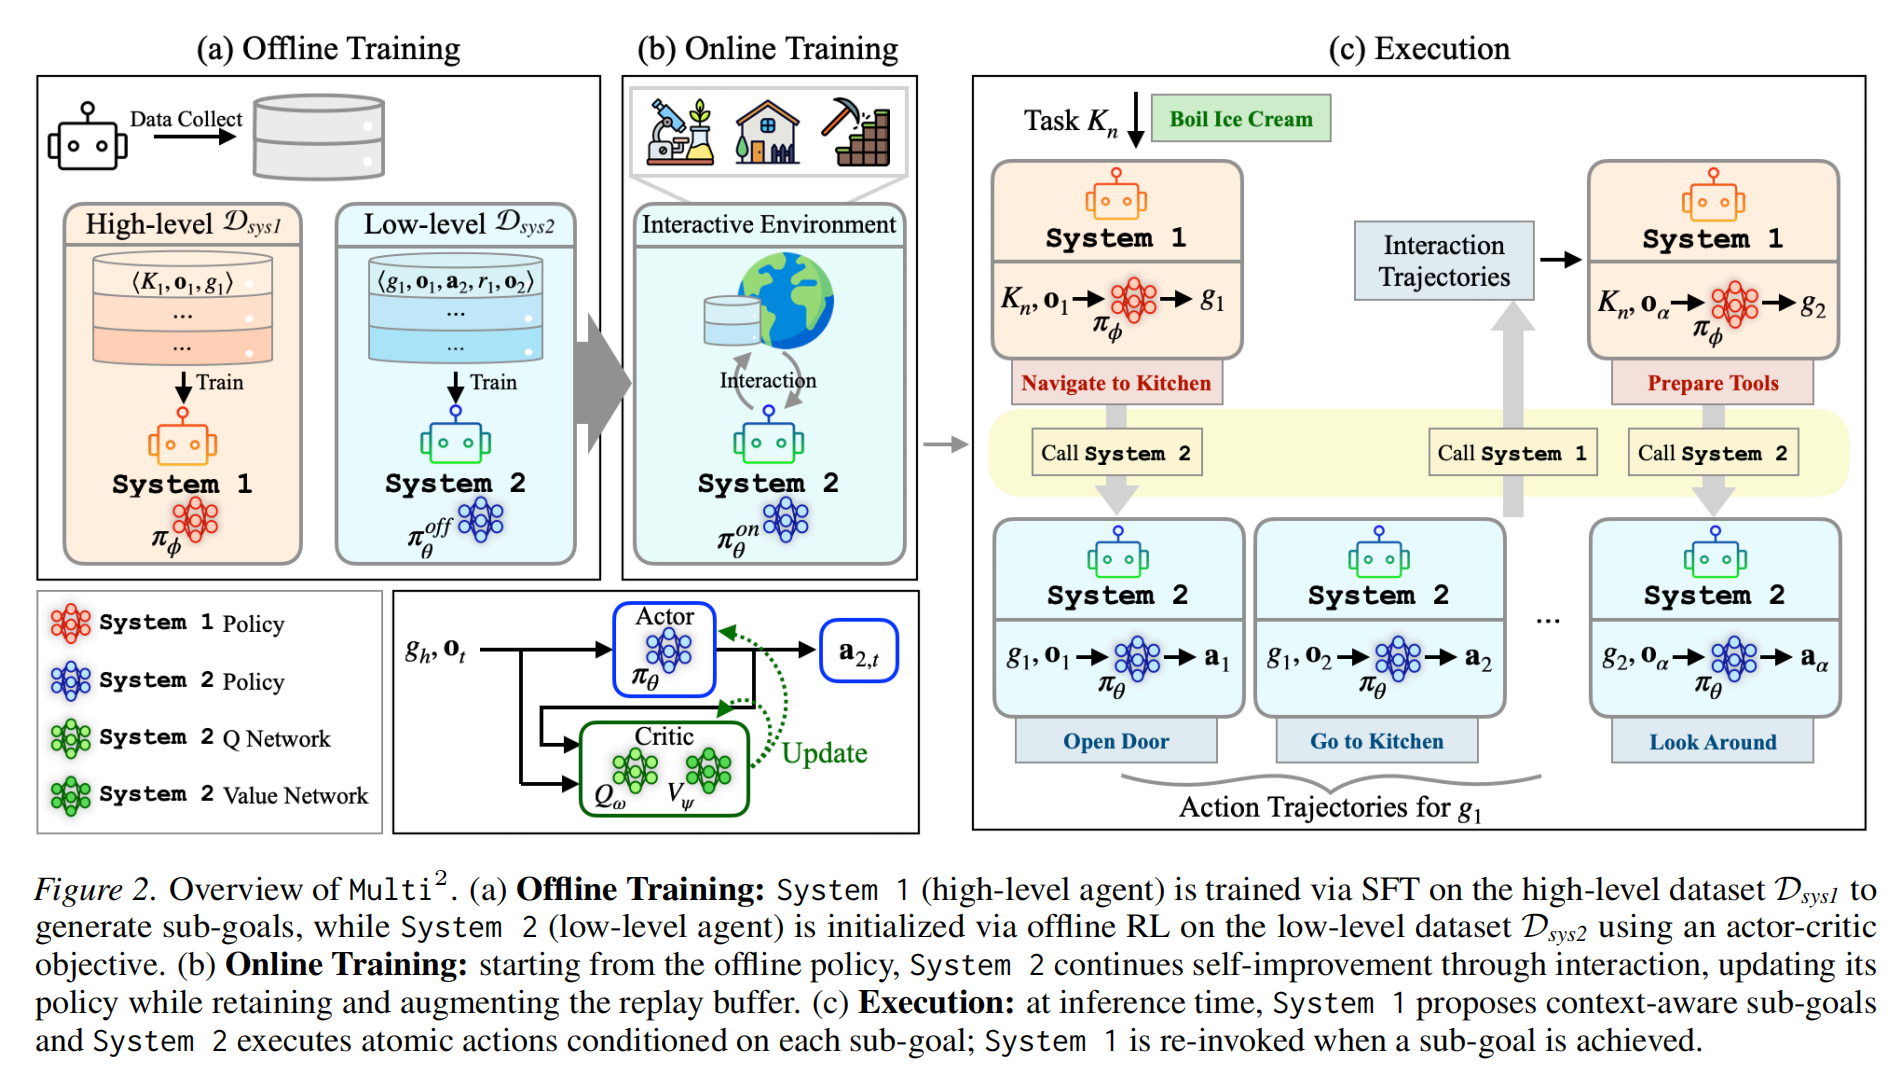
    Multi² 的核心思想是将智能体行为拆分为两个互补角色。高层智能体 System 1 负责根据任务目标和环境观察生成上下文相关的子目标,主要承担规划功能。低层智能体 System 2 负责根据当前子目标执行具体原子动作,主要承担环境交互与动作控制功能。System 1 使用监督微调训练,以保证子目标生成的稳定性和一致性;System 2 则采用 offline-to-online reinforcement learning,使执行策略先从离线数据中稳定初始化,再通过在线交互持续改进。

    实验结果表明,Multi² 在 ScienceWorld、ALFWorld 和 TextCraft 等多个交互环境中整体优于 ReAct、Reflexion、ADaPT、GRPO 和 Glider 等强基线方法。相比只依赖 prompting 或普通层级规划的方法,Multi² 不仅任务完成率更高,而且在长 horizon、任务难度增加和 OOD 分布下表现更稳。论文还发布了三个层级化 benchmark datasets,用于训练和评估 LLM 智能体的层级决策能力,弥补了该方向数据资源不足的问题。

    Multi2: Hierarchical Multi-Agent Decision-Making with LLM-Based Agents in Interactive Environments插图

    2. 研究背景与问题动机(Introduction)

    构建能够在动态环境中持续交互、规划和行动的智能体,是当前 agentic AI 的重要目标。与一次性问答不同,交互环境中的智能体每执行一个动作,环境状态都会发生变化,后续决策必须基于新的观察继续进行。因此,这类任务天然具有多轮、长程和闭环反馈的特点,对智能体的目标保持能力和执行稳定性提出了更高要求。

    目前很多 LLM agent 在短任务中表现不错,但在长程任务中仍然脆弱。一个典型问题是 objective drift,即智能体在多轮交互过程中逐渐偏离原始目标。论文指出,这并不只是单纯的规划失败,而是一个交互层面的累积误差问题。前面某一步的小错误可能导致状态偏移,后续模型又基于错误状态继续推理,最终使整个轨迹越走越偏。

    已有方法通常从两个方向尝试解决这个问题。一类方法如 ReAct 和 Reflexion 依赖 prompt 和长历史上下文,让模型通过推理和自我反思维持目标。但这类方法 token 消耗较大,且长历史本身并不能保证动作执行正确。另一类方法采用层级规划,例如 ADaPT 和 Glider,将复杂任务拆成子目标,从而降低规划难度。不过,论文认为仅有任务分解还不够,因为执行器如果没有经过专门训练,仍然无法有效修正长程交互中的累积错误。

    因此,本文真正抓住的问题是,长程交互不是只需要更好的 planning,也需要更稳的 execution。一个可靠的 LLM agent 应该同时具备三点能力。首先是明确的任务分解,用来维持全局意图。其次是能够通过环境反馈不断改善的动作执行能力。最后是较高的 token efficiency,避免每一步都依赖越来越长的上下文。Multi² 正是围绕这三个需求设计的。

    3. 框架与整体设计(System Overview)

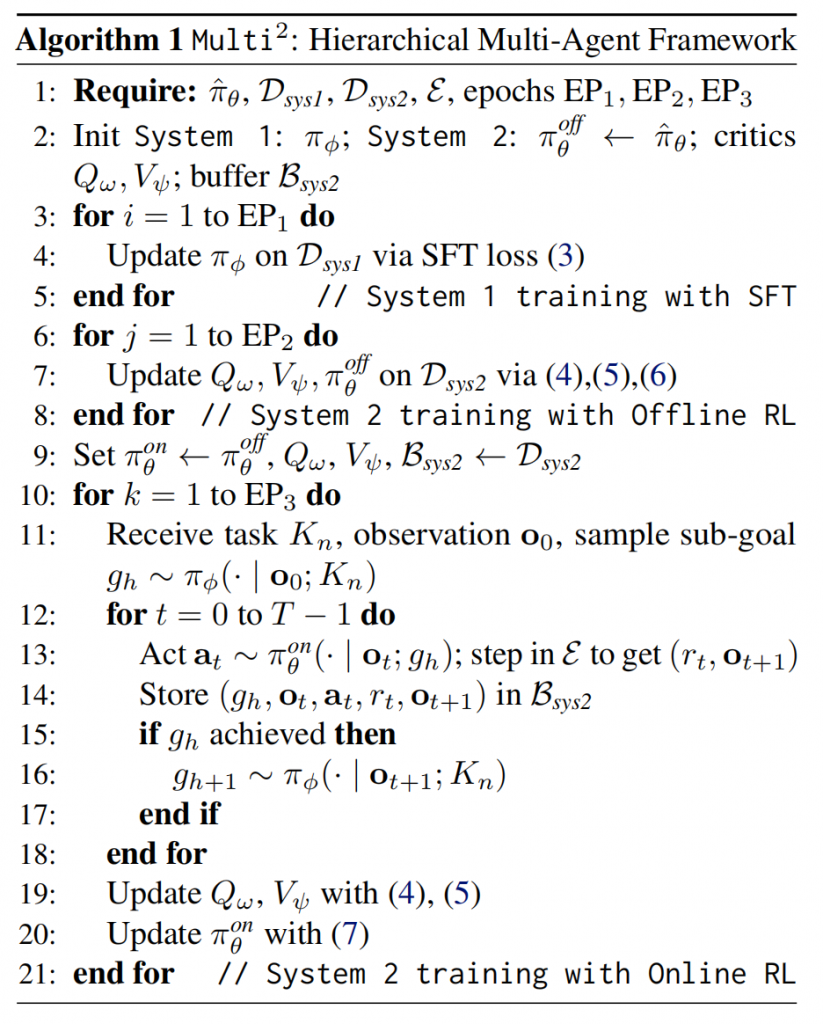
    Multi² 采用层级化多智能体结构,将原本由单个 agent 完成的长期决策任务拆解为两个角色分工明确的子系统。System 1 是高层规划器,输入任务描述和当前观察,输出下一阶段需要完成的子目标。System 2 是低层执行器,输入当前观察和 System 1 生成的子目标,输出具体的环境动作。当当前子目标完成或终止后,系统会再次调用 System 1 生成新的子目标,如此循环直到任务结束。

    这种设计的关键不只是把任务拆成上下两层,而是让两个层级分别对应不同的学习目标。System 1 负责语义层面的任务理解和子目标规划,因此更适合用 SFT 学习稳定、结构化的子目标生成。System 2 直接与环境交互,需要处理状态变化、动作约束和执行错误,因此更适合用强化学习提升动作层面的鲁棒性。

    论文将整个流程分为三个阶段。第一是 offline training,分别训练 System 1 和 System 2。第二是 online training,让 System 2 在环境交互中继续自我改进。第三是 execution,推理时 System 1 按需生成子目标,System 2 在每个子目标下连续执行原子动作。这样的选择性调用机制也减少了不必要的长上下文推理,因此能提升 token efficiency。

    相比 Glider 这类已有层级方法,Multi² 的差异在于它更强调 role specialization。Glider 虽然也有 planner 和 controller,但在在线适应时主要更新高层规划器,低层执行器相对固定,而且不同角色之间的参数隔离不够充分。Multi² 则让 System 1 和 System 2 使用独立 LoRA adapter,并针对各自角色采用不同训练方式,从而避免规划和执行职责混在一起。

    Multi2: Hierarchical Multi-Agent Decision-Making with LLM-Based Agents in Interactive Environments插图1

    4. 数据集构造与训练方法(Method)

    为了支持层级化训练,论文首先构造了两个角色专用数据集。System 1 的数据集由任务描述、观察和子目标组成,主要用于训练高层规划器学会在不同环境状态下生成合理子目标。System 2 的数据集则围绕每个子目标展开,包含观察、动作、奖励和下一步观察,用于训练低层执行器在给定子目标下选择具体动作。这样的数据划分使两个系统的训练目标更加清晰,也避免了单一数据格式同时承担规划和执行两类任务。

    System 1 的训练相对直接,作者使用 SFT 对高层规划器进行行为克隆,使其模仿专家轨迹中的子目标生成过程。这样做的原因是,高层规划更偏语义理解和任务分解,目标是保持计划结构稳定,而不是通过环境探索不断试错。因此,SFT 在这里更合适,也更容易保证生成子目标的一致性。

    System 2 的训练更复杂。由于低层执行器直接面对动态环境,单纯模仿离线轨迹容易过拟合,也难以处理环境变化带来的状态偏移。因此,作者使用 actor critic 形式的 offline RL 初始化 System 2。critic 学习动作价值和状态价值,actor 则结合 advantage 信息更新策略,使模型不仅模仿离线数据中的动作,也倾向于选择估计回报更高的动作。论文还加入 policy anchored advantage term,用来减轻过度模仿,提高策略在离线轨迹之外的迁移能力。

    在 online training 阶段,System 2 从离线训练得到的策略出发,继续与环境交互,并把新轨迹加入 replay buffer。在线更新中,作者引入 KL regularization,使新策略不会过度偏离离线策略。这样既允许 System 2 通过在线交互修正执行错误,又避免策略更新过猛导致崩溃或 mode collapse。整体来看,这套 offline-to-online RL 设计的重点不是单纯追求更强优化,而是让低层执行器在长程交互中更稳定地自我改进。

    Multi2: Hierarchical Multi-Agent Decision-Making with LLM-Based Agents in Interactive Environments插图2

    5. 实验设置(Experimental Setup)

    论文在三个交互环境上评估 Multi²,分别是 ScienceWorld、ALFWorld 和 TextCraft。ScienceWorld 更强调科学任务中的长程规划和状态变化,ALFWorld 更偏家庭场景中的物体操作和稀疏奖励,TextCraft 则关注符号化 crafting 任务中的组合依赖和目标保持。这三个环境共同覆盖了不同类型的长程交互场景,因此比较适合检验智能体是否真的具备稳定的多轮决策能力。

    模型方面,作者使用 Qwen 2.5 3B、Mistral 7B v0.3 和 Llama 3.1 8B 作为 backbone,并通过 LoRA 进行参数高效微调。System 1 和 System 2 共享同一个预训练 backbone,但使用不同的 LoRA adapter。在训练和推理时,只激活当前系统对应的 adapter。这个设计既节省训练成本,又能保证规划器和执行器具备一定参数隔离。

    评价指标采用严格的 pass@1,即每个任务只允许一次 rollout,不进行多次重试或采样。这一点比较重要,因为它更能反映 agent 的一次性任务完成能力,而不是依靠多次尝试碰运气。论文还区分 ID 和 OOD splits,ID 任务和训练集共享任务模板或交互模式,但具体环境实例仍不同;OOD 任务则使用新的任务模板,更能考察泛化能力。

    对比方法包括 prompt-based 和 fine-tuning-based 两大类。prompt-based 方法包括 ReAct、Reflexion 和 ADaPT,fine-tuning-based 方法包括 GRPO 和 Glider。这样的基线设置比较完整,既覆盖了非层级方法,也覆盖了已有层级方法,还能区分 prompt 方案和参数更新方案之间的差异。

    Multi2: Hierarchical Multi-Agent Decision-Making with LLM-Based Agents in Interactive Environments插图3

    6. 实验结果与性能分析(Experiments)

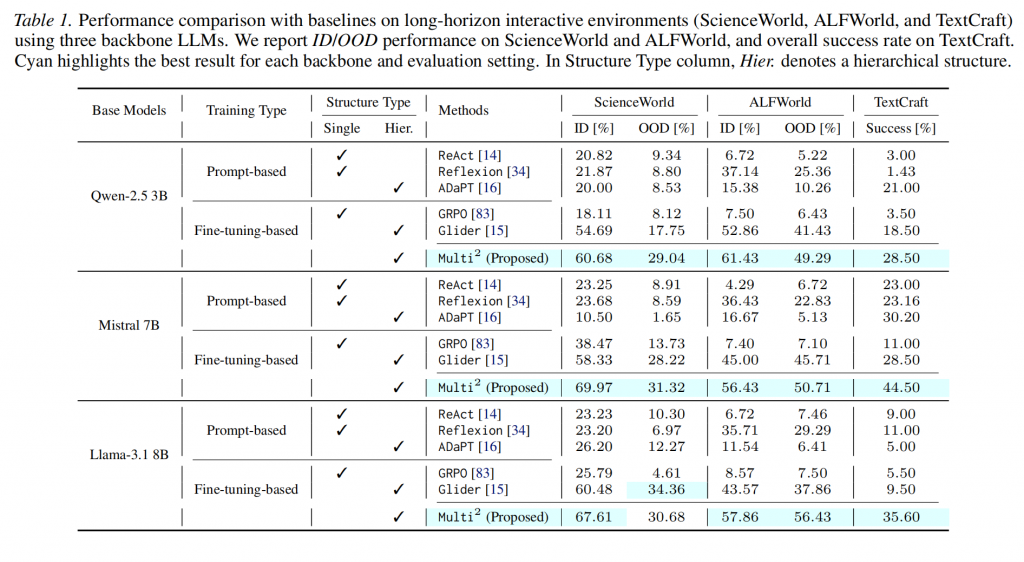
    主实验结果显示,Multi² 在大多数设置下取得最佳表现。以 Qwen 2.5 3B 为例,Multi² 在 ScienceWorld ID 上达到 60.68,在 ScienceWorld OOD 上达到 29.04,在 ALFWorld ID 和 OOD 上分别达到 61.43 和 49.29,在 TextCraft 上达到 28.50。以 Mistral 7B 为例,Multi² 在 ScienceWorld ID 上达到 69.97,在 TextCraft 上达到 44.50,也明显超过多数基线。以 Llama 3.1 8B 为例,Multi² 在 ALFWorld ID 和 OOD 上分别达到 57.86 和 56.43,在 TextCraft 上达到 35.60。整体来看,Multi² 对不同模型规模和不同环境都具有较强适用性。

    从方法类别看,prompt-based 方法整体表现较弱,尤其在长程任务中容易出现错误累积。ADaPT 由于引入层级 prompting,在部分任务上比 ReAct 和 Reflexion 更好,说明任务分解本身确实有价值。GRPO 作为单 agent RL 方法在一些场景中效果有限,说明简单强化学习并不能自然解决长程目标保持问题。Glider 作为层级微调基线表现明显更强,但仍然不如 Multi²,这说明层级结构之外,角色专用训练和低层执行器的在线自我改进同样重要。

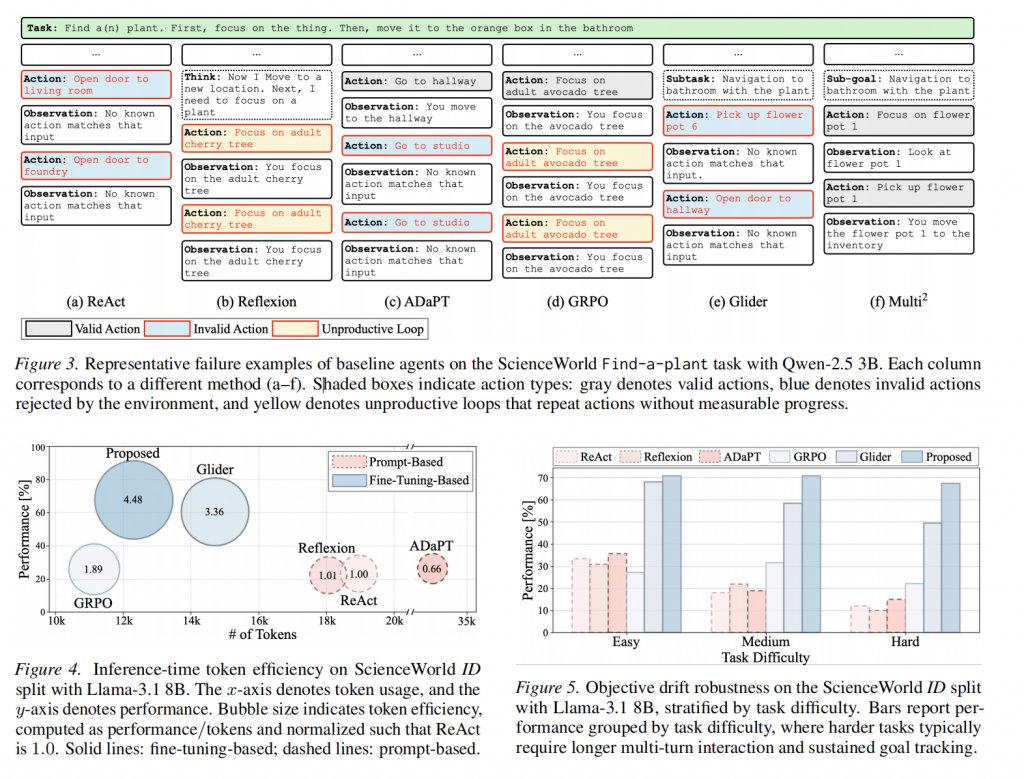
    论文还给出了定性错误分析。Figure 3 展示了 ScienceWorld 中 Find a plant 任务的典型失败案例。ReAct、Reflexion 和 ADaPT 等方法容易产生被环境拒绝的非法动作,或者陷入重复执行但没有进展的循环。GRPO 和 Glider 虽然经过训练,但也可能持续朝着不合理目标执行。相比之下,Multi² 能通过明确子目标约束执行方向,同时利用 RL fine tuning 提高动作有效性,因此更少出现目标漂移和无效循环。

    token efficiency 方面,Figure 4 显示 Multi² 在 ScienceWorld ID split 上用更少 token 获得更高性能。其原因在于层级框架并不需要每一步都把完整历史和复杂提示塞给同一个 agent,而是按需调用 System 1 生成子目标,再由 System 2 执行具体动作。这样既减少长 prompt 依赖,也让低层动作输出更稳定。

    在 objective drift robustness 分析中,Figure 5 按任务难度展示了不同方法的性能。随着任务从 easy 到 hard,prompt-based 方法退化明显,fine-tuning-based 方法虽然更强,但在 hard 任务上仍有下降。Multi² 在困难任务上优势更明显,说明它对长 horizon 和持续目标跟踪更鲁棒。这也是全文很重要的实验支撑,因为它直接回应了论文开头提出的 objective drift 问题。

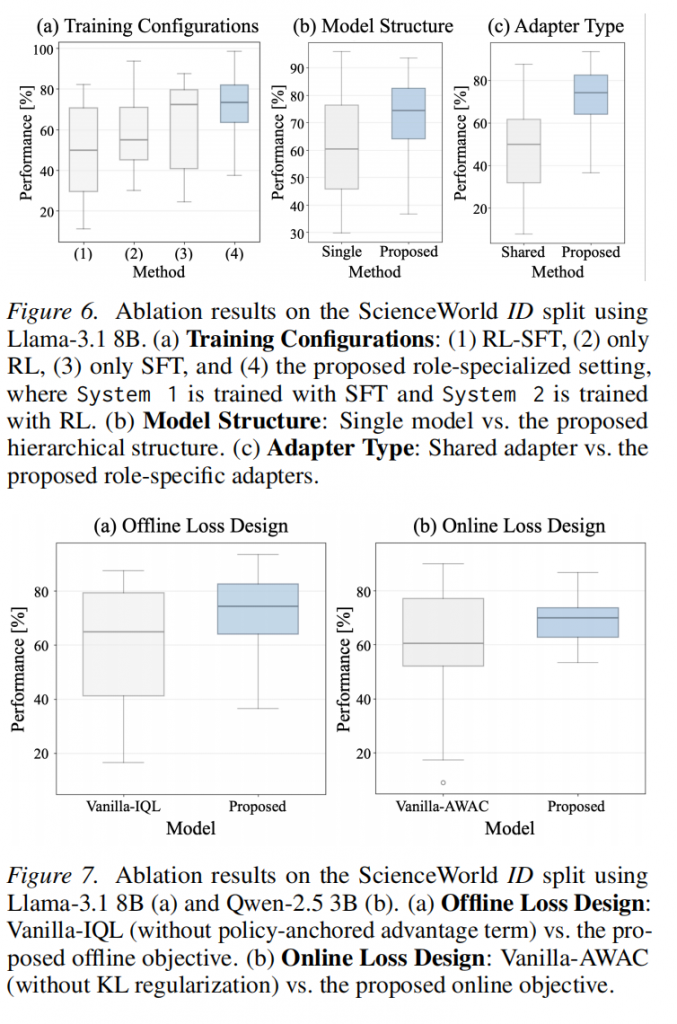
    消融实验进一步说明各模块都有必要。Figure 6 显示,System 1 用 SFT、System 2 用 RL 的角色匹配方式表现最好。如果交换训练方式,让 System 1 用 RL、System 2 用 SFT,效果最差,说明规划和执行不能随便套用同一种训练范式。Figure 6 还显示,层级结构优于单模型结构,role-specific adapter 优于 shared adapter。Figure 7 则说明,policy anchored offline objective 和 KL regularized online objective 都有助于提高稳定性。

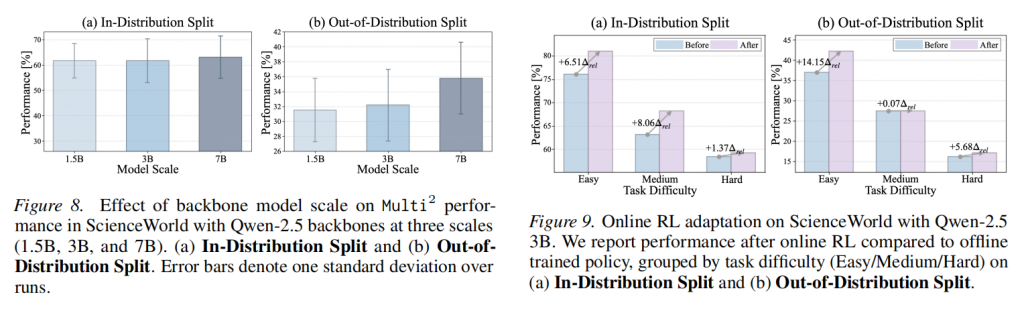
    最后,Figure 8 和 Figure 9 分别分析了模型规模和在线适应效果。Figure 8 显示,在 ID split 上不同 Qwen 规模差异不大,但在 OOD split 上模型越大表现越好,说明更大 backbone 对分布外泛化更有帮助。Figure 9 显示,online RL 能进一步提升执行可靠性,尤其在 OOD split 上收益更明显,说明在线交互确实能够帮助 System 2 修正离线训练中无法覆盖的执行错误。

    Multi2: Hierarchical Multi-Agent Decision-Making with LLM-Based Agents in Interactive Environments插图4
    Multi2: Hierarchical Multi-Agent Decision-Making with LLM-Based Agents in Interactive Environments插图5
    Multi2: Hierarchical Multi-Agent Decision-Making with LLM-Based Agents in Interactive Environments插图6

    7. 贡献与结论(Contributions and Conclusion)

    本文的主要贡献可以概括为四点。

    第一,提出 Multi² 层级化多智能体框架,将长程交互任务中的 planning 和 execution 分别建模为不同优化问题。System 1 负责生成上下文相关子目标,System 2 负责在动态环境中执行原子动作,从结构上缓解目标漂移。

    第二,设计了 role-specialized training pipeline。System 1 使用 SFT 保持高层规划稳定,System 2 使用 offline-to-online RL 提升动作执行鲁棒性。这种训练分工与两个系统的功能定位一致,比简单用一个 agent 或一个共享 adapter 更合理。

    第三,提出面向 System 2 的 offline-to-online RL 目标,在离线阶段通过 critic guided policy anchoring 减轻过度模仿,在在线阶段通过 KL regularization 避免策略更新不稳,从而实现更安全的自我改进。

    第四,论文发布了面向层级智能体训练与评估的数据集,并在 ScienceWorld、ALFWorld 和 TextCraft 上验证了 Multi² 在性能、token efficiency 和长程鲁棒性上的优势。

    整体来看,这篇论文真正有价值的地方在于,它没有把长程交互失败简单归因于模型能力不够,而是把问题拆成了规划漂移、执行误差累积和 token 效率低三个层面。Multi² 的设计也对应这三个层面分别处理,用 System 1 保持目标,用 System 2 稳定执行,用按需调用降低 token 消耗。它的研究问题比较清楚,实验闭环也较完整,适合作为 LLM agent 长程决策方向的一篇阅读论文。

  • 智能体网络的体系结构挑战与演进路径

    智能体网络的体系结构挑战与演进路径

    摘要:大模型应用正在从生成式交互走向行动式协作。智能体不再只是回答问题,而是代表用户调用模型、访问内容、执行工具、写入状态并协调多个服务。这一变化使网络面对的核心问题从“端到端可达”扩展为“任务链路可控”:主体身份如何确认,委托授权如何传递,能力如何发现,内容如何鉴权,资源消耗如何归因,状态变更如何追踪。本文以智能体网络为中心对象,分析行动型智能体对未来网络体系结构提出的新要求,并将智能生态网络(Intelligent Eco Networking,IEN)放置在 Internet of Agents、DID、零信任、KDN、IBN、CATS 与大模型推理系统等相关技术线索中加以讨论。文章认为,IEN 的价值不在于替代上述技术方向,而在于为这些分散问题提供统一的跨层组织视角,将内容识别、知识驱动、可信协作、资源度量与价值导向纳入同一任务协同基础设施框架。
    关键词:智能体网络;智能生态网络;未来互联网;知识驱动;可信协作;资源协同;计算感知路由

    引言:从连接智能体到支撑智能体行动

    近年来,Internet of Agents、Model Context Protocol、Agent2Agent Protocol、DID、零信任、CATS 以及大模型推理服务系统的发展表明,智能体时代的网络问题正在从端到端连通性扩展到身份委托、能力发现、内容授权、资源调度、状态追踪与审计归因。本文以行动型智能体任务链路为对象,讨论未来网络从“连通性支撑”走向“任务协同基础设施”的体系结构需求,并从 IEN 视角分析其跨层组织可能。
    本文所称“智能体网络”,并非简单的多智能体聊天系统,而是由用户、智能体、模型服务、工具服务、数据服务、缓存节点与计算节点共同构成的任务协作网络。在这种网络中,请求不再只是一次输入输出,而是可能演化为一条跨主体、跨系统、跨资源域的行动链。
    由此产生的核心变化是,网络不再只是连接端点的传输管道,而逐渐成为组织身份、内容、能力、资源与任务上下文的基础设施。若这一变化仍被完全留给应用层以临时方式处理,智能体系统的授权边界、资源成本、状态一致性和责任追踪都会变得难以控制。
    本文的中心观点是,行动型智能体推动网络体系结构从“连通性支撑”转向“任务协同支撑”。IEN 的启发不在于替代 NDN/ICN、DID、零信任、CATS 或智能体协议,而在于将内容识别、知识驱动、可信协作、资源度量与价值导向放在同一网络生态视角下重新组织。与 NDN/ICN 更侧重内容命名、缓存与数据中心通信不同,本文关注的是行动型智能体任务链路中的委托、能力、状态、成本与责任归因问题。

    一、行动型智能体的网络基础设施需求

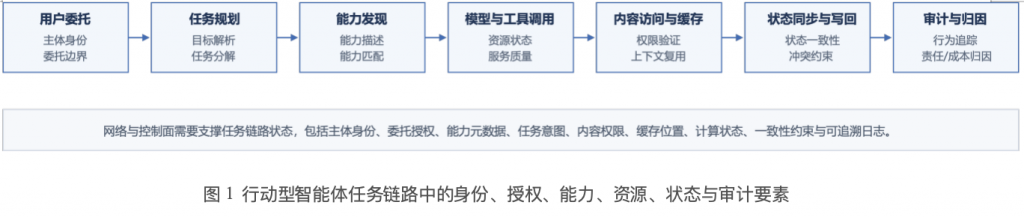
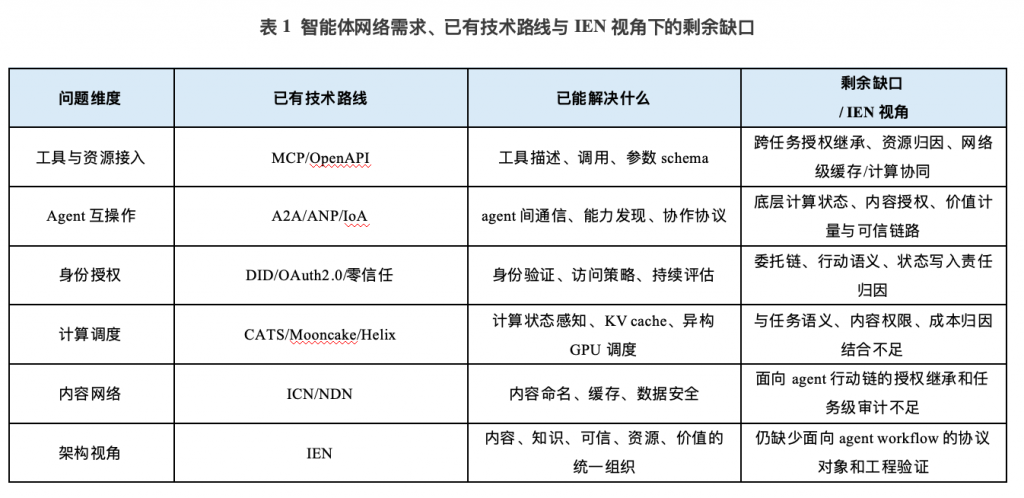
    行动型智能体将网络问题从“请求能否送达”推进到“行动能否被可靠执行”。当智能体仅承担问答式推理时,网络主要负责将请求路由到模型服务并返回结果。当智能体开始代表用户执行操作时,网络化基础设施需要与控制面、安全机制和服务编排层协同组织身份、授权、能力、资源与状态等多维信息。
    第一,身份与委托授权需要在任务链路中持续表达。一次智能体任务可能由用户发起,经由智能体规划,再调用模型、工具、数据库或第三方服务。链路中的每一步都需要明确请求由谁发起、代表谁行动、被允许执行哪些动作,以及授权是否仍然有效。
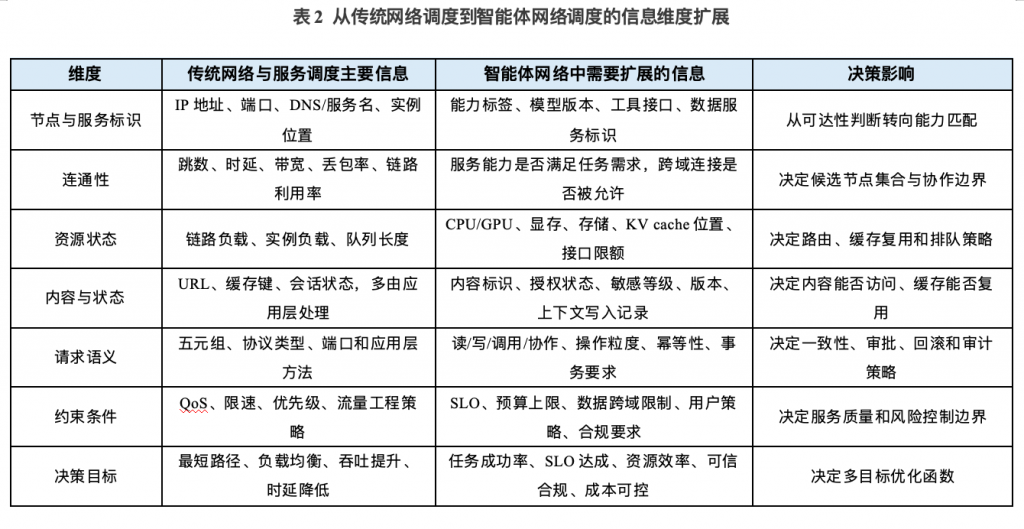
    第二,能力发现与任务匹配成为网络协作的前置条件。智能体网络中的节点不只是地址或端口,而可能是模型、工具、数据集、执行环境或组合服务。任务调度的目标不只是找到“可达节点”,而是找到能力、成本、可信性与约束条件共同满足要求的协作者。
    第三,资源消耗需要被细粒度度量并归因到任务。一次复杂任务可能涉及多次模型调用、上下文缓存复用、数据读写、工具执行和跨节点传输。若缺乏统一的资源计量机制,系统很难判断一次行动的真实成本,也难以建立公平的计费、审计和服务等级保障。
    第四,任务状态需要具备跨节点可追溯性。行动型任务通常包含多个具有依赖关系的子步骤。当授权失败、工具异常、节点超时或状态写入冲突发生时,系统需要知道故障发生在何处、影响了哪些后续步骤、是否需要回滚或补偿,以及责任应如何界定。
    这些要求并不完全属于传统网络层,也不能完全交给应用层孤立处理。更合理的方向是让网络控制面、服务编排层与安全机制共同暴露面向行动语义的基础能力,从而使智能体任务具备可控、可计量和可追溯的运行条件。

    智能体网络的体系结构挑战与演进路径插图

    二、自主协作系统带来的体系结构复杂性

    上述需求之所以构成体系结构问题,并不是因为每一项机制本身前所未有,而是因为它们在行动型智能体场景中被同时激活,并沿着任务链路发生耦合。智能体网络的复杂性并非单纯来自模型规模,而是来自自主性、协作关系和状态变更共同形成的系统效应。相关研究虽然关注角度不同,但共同指向一个趋势:人工智能系统的关键挑战正在从模型内部能力扩展到外部基础设施的组织方式。
    自主等级首先改变了部署风险的性质。Morris 等在 ICML 2024 论文中提出,评估 AI 系统不能只看性能和通用性,还需要考虑自主性所带来的部署风险[1]。对网络基础设施而言,这意味着不同自主等级的智能体请求应当携带不同的控制语义,例如是否允许自动执行、是否需要人工确认、是否允许写入外部状态,以及是否需要更高等级的日志审计。
    用户监督角色进一步改变了责任边界。Feng 等将用户在智能体系统中的角色划分为操作者、协作者、顾问、审批者和旁观者五类[2]。当用户从直接操作者转变为审批者或旁观者时,系统必须通过基础设施机制补足控制能力,包括可验证委托链、条件性执行阻断、异常回滚和责任追踪。
    多主体协作使智能表现出关系性和社会性特征。Evans 等在 Science 文章中指出,智能并非只能理解为单体模型能力,而可以表现为多个主体之间的社会性、关系性交互[3]。这一判断对网络体系结构的启示是:智能体之间的协作需要显式表达任务依赖、状态依赖和冲突解决机制,而不是仅依赖自然语言对话或应用层临时约定。
    状态写入则使经典系统问题重新出现。只读查询可以容忍缓存、重试和近似一致性,但写操作、审批流程、资金转移、数据更新和项目管理任务涉及事务、持久化、原子性和补偿逻辑。Stonebraker 关于数据库未来问题的讨论也表明,当系统开始组织真实工作流时,事务和状态管理仍是基础设施无法绕开的核心问题[4]。
    因此,智能体网络的体系结构挑战不能简化为“给智能体提供通信协议”。更准确地说,它需要在通信、身份、能力、资源、内容、状态与治理之间建立统一的控制关系。

    三、IEN作为跨层整合的架构视角

    面对行动型智能体释放出的跨层复杂性,IEN 的价值在于提供一种整合性问题视角。它不应被理解为替代所有现有协议和系统的单一方案,而应被视为一种将内容、知识、可信关系、资源状态和价值关系共同纳入网络体系结构的框架。

    IEN 2020 年论文将其概括为知识驱动和价值导向的未来互联网基础设施[7]。这一表述的关键不只是“智能化网络控制”,而是把网络看成由内容、主体、资源和价值关系共同构成的生态系统。相较于以地址、路径和转发为主要抽象的传统 IP 网络,IEN 更强调内容标识、授权关系、可信协作、资源度量和任务导向的动态组织。

    后续 IEN II 继续强调知识驱动与价值导向的生态系统视角[8],IEN III 则提出共享网内计算基础设施的概念[9]。这些工作与当前大模型服务和算力网络具有可比性:在长上下文推理、KV cache 复用、异构 GPU 调度和跨节点服务编排中,计算、缓存、路由和资源状态已经难以分离。

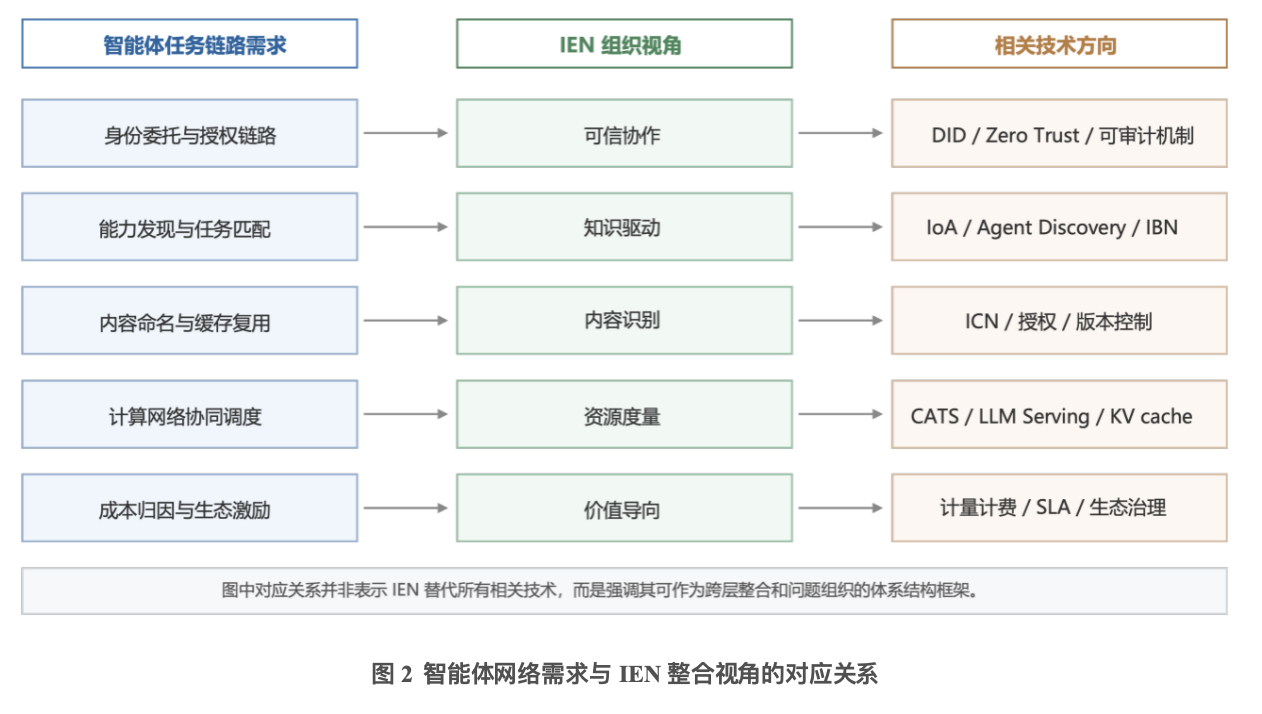
    从智能体网络角度看,IEN 的整合性可以体现在五个方面:内容不再只是被传输的数据,而是需要命名、授权、缓存和复用的对象;知识不再只是模型内部参数,而是可进入控制面的能力、意图和约束表达;可信不再只是边界防护,而是跨主体委托关系的持续验证;资源不再只是带宽和时延,而包括算力、存储、队列、缓存和成本;价值不再只是商业计费,而涉及激励、归因、合规和生态可持续。

    这一定位有助于避免两种偏差,一是把智能体网络退化为应用层工作流编排,忽视网络基础设施的作用;二是把 IEN 表述为包打天下的封闭体系,忽视 DID、零信任、KDN、IBN、CATS 和大模型服务系统等相关方向的独立贡献。更有说服力的写法是:先定义智能体网络问题,再说明 IEN 为这些问题提供了统一组织框架。

    智能体网络的体系结构挑战与演进路径插图1
    智能体网络的体系结构挑战与演进路径插图2

    四、知识驱动控制面的能力、意图与约束建模

    本文所说的知识驱动,并不是指网络中存在一个集中式全局知识库,也不是简单把大模型接入控制面,而是指能力、意图、约束、资源状态和可信关系能够以机器可处理的形式进入调度与控制过程。若“知识驱动”要成为可操作的网络机制,就必须回答网络需要知道什么,以及这些知识如何影响决策。面向智能体网络,最关键的知识并非全局知识库,而是能够进入控制面和调度过程的能力、意图、约束与资源状态。
    能力描述是智能体协作的入口。Agent Discovery 研究指出,大规模智能体协作需要能力表示、语义建模、可更新索引、上下文感知搜索、候选排序和组合机制[6]。这意味着智能体要发现的不再是某个 IP 地址,而是具有特定模型能力、工具能力、数据访问能力或执行能力的服务节点。
    意图表达决定授权、路由和一致性策略。一次请求是读操作还是写操作,是短查询还是长上下文推理,是单工具调用还是多智能体协作,是可重试任务还是不可重复执行任务,这些差异直接影响缓存策略、审批要求、事务机制和审计粒度。
    约束条件决定系统可接受的行动边界。智能体任务可能受到数据跨域限制、隐私合规要求、人工审批要求、预算上限、服务等级目标和用户策略约束。缺乏这些约束,调度系统只能依赖负载、时延或最短路径等少数指标,难以满足行动型任务的风险控制要求。
    资源状态使知识驱动从语义层进入工程层。对大模型服务而言,可用 GPU、显存、队列长度、KV cache 位置、带宽、存储和失败率都会影响请求路由;对智能体任务而言,工具可用性、接口限额、内容权限和状态锁也会影响执行路径。知识驱动控制面需要把这些信息转化为可计算、可更新、可验证的决策输入。
    KDN 和 IBN 为这一方向提供了重要参照。KDN 尝试将网络分析、机器学习与 SDN 控制结合起来,以优化网络行为[13];IBN 则强调用高层目标、策略和约束表达网络意图,而不是暴露底层配置命令[14]。IEN 与二者的差异在于,它并不只讨论控制优化,而是把知识驱动放在内容、可信、资源和价值关系共同作用的网络生态中。
    因此,知识驱动控制面的实际价值不在于构建一个集中掌握全部信息的全局大脑,而在于让能力、意图、约束和资源状态能够以可计算形式参与网络决策。只有当这些信息进入调度过程,智能体请求才可能被路由到合适、可信、成本可控且权限清晰的协作者。

    智能体网络的体系结构挑战与演进路径插图3

    五、面向委托行动的身份授权与可追溯机制

    在智能体网络中,身份验证和授权不再是一次性登录问题,而是持续存在于任务链路中的委托关系问题。一个智能体可能代表用户调用工具,工具再调用下游服务,下游服务进一步访问内容、缓存或数据库。链路中的每一步都需要回答请求主体是谁,授权从何而来,允许执行何种动作,执行结果能否被追踪。
    DID Core 提供了可验证、去中心化身份标识的参照,但 DID 本身并不等同于完整授权系统[11]。零信任架构则将安全防护重点从静态边界转向用户、设备、应用和资源本身,强调访问请求需要持续评估和动态授权[12]。这些方向共同说明,智能体网络中的可信机制不能只依赖“内网可信”或“入口登录”。
    IEN 相关内容鉴授权思路提供了一个更贴近网络流程的例子。内容在网络中被缓存、转发和复用时,授权不能只发生在应用入口,还需要嵌入内容请求、缓存命中、授权查询、内容返回和审计记录等环节[18]。这与智能体访问缓存数据、复用上下文或调用受保护工具的场景高度相关。
    以办公智能体读取缓存文档为例,系统不能只判断该智能体能否连接缓存节点,还需要判断其代表的用户是谁,文档是否允许被该任务读取,缓存版本是否有效,后续工具调用是否继承该授权,以及整个链路是否可被审计。若其中任一环节缺失,智能体行动就可能出现越权访问、不可追踪复用或责任边界不清。
    由此可见,面向智能体网络的可信机制需要从“主体身份”扩展到“委托链路”,从“访问控制”扩展到“内容与行动的联合授权”,从“日志记录”扩展到“跨节点可追溯”。IEN 的意义在于把这些机制放入同一网络生态框架中讨论,而不是把它们分别留给应用、安全和运维系统孤立处理。

    六、计算感知路由与缓存协同调度

    智能体网络中的请求路由已经超越传统负载均衡。特别是在大模型推理服务中,请求目标节点的选择不仅取决于网络时延和实例负载,还取决于上下文缓存、GPU 队列、显存、模型部署、工具可用性和服务等级目标。
    一个典型场景是连续对话中的 KV cache 复用。若前几轮对话产生的 KV cache 存储在某个节点,而后续请求被路由到另一个无相关缓存的节点,系统将承担重新加载上下文、重复计算、跨节点传输和排队延迟等多重代价。此时,调度决策不再是“哪个节点空闲”,而是“哪个节点在延迟、成本、缓存命中率和资源占用之间形成最优组合”。
    Mooncake 和 Helix 展示了大模型服务系统中计算、缓存与网络紧密耦合的趋势。Mooncake 将 KV cache 置于服务架构核心,通过分离 prefill 与 decode 并构建 KV cache 中心化调度来提升长上下文服务效率[16];Helix 则将异构 GPU 与网络连接纳入统一建模,通过最大流思想联合优化模型放置和请求调度[17]。
    CATS 工作组也从网络标准化角度提出了类似问题,即在流量引导时同时考虑网络状态与计算服务状态,而不是只根据静态地址或连通性进行转发[15]。这表明计算感知路由已经成为未来网络和云边协同基础设施中的明确研究方向。
    IEN 相关网内资源调度专利从另一个角度回应了这一问题。相关方案将 CPU、内存、响应时延、数据传输时延、功能函数、空闲算力、存储资源、接口偏好、相邻一跳网络状态与网内资源分布状态等因素纳入调度决策[19][20][21]。这些机制未必直接等同于当前 LLM serving 系统,但其共同思想是把资源状态和调度决策更深地纳入网络内部。
    对智能体网络而言,计算感知路由还需要进一步结合任务语义。模型调用、内容访问、工具执行和状态写回分别对应不同的资源消耗和风险级别。若网络控制面无法理解任务调用了什么模型、访问了什么内容、是否存在可复用上下文、是否需要事务保证,以及成本如何归因,智能体协作就很难做到可控、可信和可计量。
    因此,资源协同不只是算力调度问题,而是任务意图、内容状态、缓存位置、服务质量和价值归因的联合优化问题。IEN 的资源度量与价值导向视角可以为这一问题提供较完整的组织框架。

    七、结语:从传输网络到任务协同基础设施

    智能体互联网并非简单增加更多智能体,大模型基础设施也并非单纯堆叠更多 GPU。真正的体系结构难点在于中间层,智能体需要行动,模型需要调用,内容需要授权,缓存需要复用,资源需要调度,状态需要追踪,成本和责任需要归因。

    这些问题正在推动网络抽象发生变化。网络处理的对象不再只是数据包和地址,还包括内容、能力、意图、状态和任务链路。网络优化的目标不再只是吞吐、时延和可达性,还包括可信、合规、成本、服务等级和生态可持续。网络治理的边界也不再只是设备管理,而延伸到委托关系、价值交换和责任审计。

    已有研究分别从不同侧面回应了这一变化。DID 和零信任关注身份与访问控制,KDN 和 IBN 关注知识与意图进入网络控制,CATS 关注计算状态感知的流量引导,Mooncake 和 Helix 展示了大模型服务中的缓存与资源调度,Internet of Agents 和 Agent Discovery 则讨论大规模智能体互联和能力发现[5][6]。

    IEN 对本文问题的启发在于,它把内容识别、知识驱动、可信协作、资源度量和价值导向放入同一未来网络框架中。若从智能体网络视角重新理解,IEN 并不是要替代所有相关技术,而是提供一种跨层问题组织方法:将分散在应用层、安全层、控制面、算力层和内容层的问题,重新纳入统一的网络生态结构。

    因此,未来值得进一步展开的方向不是抽象地宣称“AI 需要新网络”,而是围绕智能体网络建立更具体的研究问题:如何表达能力和意图,如何传递可验证委托,如何对内容和缓存进行授权,如何让计算状态参与路由,如何记录任务因果链路,以及如何形成可审计、可计量、可治理的协作生态。

    当智能体开始跨组织、跨平台、跨资源域执行任务时,网络将不再只是连接系统的管道,而会成为智能系统可靠运行的任务协同基础设施。

    参考资料与延伸阅读

    [1] Meredith Ringel Morris et al., Position: Levels of AGI for Operationalizing Progress on the Path to AGI, ICML / PMLR, 2024. https://proceedings.mlr.press/v235/morris24b.html
    [2] K. J. Kevin Feng, David W. McDonald, Amy X. Zhang, Levels of Autonomy for AI Agents, arXiv:2506.12469, 2025. https://arxiv.org/abs/2506.12469
    [3] James Evans, Benjamin Bratton, Blaise Agüera y Arcas, Agentic AI and the next intelligence explosion, Science, 2026, DOI: 10.1126/science.aeg1895. https://www.science.org/doi/10.1126/science.aeg1895
    [4] Developing.dev, Turing Award Winner: Postgres, Disagreeing with Google, Future Problems | Mike Stonebraker, 2026. https://www.developing.dev/p/turing-award-winner-postgres-disagreeing
    [5] Yuntao Wang et al., Internet of Agents: Fundamentals, Applications, and Challenges, IEEE Transactions on Cognitive Communications and Networking, 2025, DOI: 10.1109/TCCN.2025.3623369; arXiv:2505.07176.
    [6] Shaolong Guo, Yuntao Wang, Zhou Su, Yanghe Pan, Qinnan Hu, Tom H. Luan, Agent Discovery in Internet of Agents: Challenges and Solutions, IEEE Network, 2026; arXiv:2511.19113. https://arxiv.org/abs/2511.19113
    [7] 雷凯、黄硕康、方俊杰、黄济乐、谢莹莹、彭博. Intelligent Eco Networking (IEN): Knowledge-Driven and Value-Oriented Future Internet Infrastructure. Journal of Applied Sciences, 2020. DOI: 10.3969/j.issn.0255-8297.2020.01.012
    [8] Lei Kai, Huang Shuokang, Huang Jiyue, Liu Huafang, Liu Jin. Intelligent Eco Networking (IEN) II: A Knowledge-Driven Future Internet Infrastructure for Value-Oriented Ecosystem. IEEE HotICN, 2019. https://ieeexplore.ieee.org/abstract/document/9063217/
    [9] Shuokang Huang, Ruibiao Chen, Yu Li, Meimei Zhang, Kai Lei, Ting Xu, Xiquan Yu. Intelligent Eco Networking (IEN) III: A Shared In-network Computing Infrastructure towards Future Internet. IEEE HotICN, 2020. https://ieeexplore.ieee.org/abstract/document/9350853/
    [10] ICNLab. 智能生态网络 IEN 2022:面向 Web3.0 的内容中心链网融合架构, 2022. https://www.icnlab.cn/?p=6505
    [11] W3C DID Working Group. Decentralized Identifiers (DIDs) v1.0. W3C Recommendation, 2022. https://www.w3.org/TR/did-core/
    [12] Scott Rose, Oliver Borchert, Stu Mitchell, Sean Connelly. Zero Trust Architecture. NIST SP 800-207, 2020. https://doi.org/10.6028/NIST.SP.800-207
    [13] Albert Mestres et al. Knowledge-Defined Networking. ACM SIGCOMM Computer Communication Review, 2017. https://doi.org/10.1145/3138808.3138810
    [14] Alexander Clemm et al. Intent-Based Networking – Concepts and Definitions. RFC 9315, 2022. https://www.rfc-editor.org/rfc/rfc9315
    [15] IETF CATS WG. A Framework for Computing-Aware Traffic Steering (CATS). Internet-Draft, 2026. https://datatracker.ietf.org/doc/draft-ietf-cats-framework/
    [16] Ruoyu Qin et al. Mooncake: A KVCache-centric Disaggregated Architecture for LLM Serving. arXiv:2407.00079, 2024. https://arxiv.org/abs/2407.00079
    [17] Yixuan Mei, Yonghao Zhuang, Xupeng Miao, Juncheng Yang, Zhihao Jia, Rashmi Vinayak. Helix: Serving Large Language Models over Heterogeneous GPUs and Network via Max-Flow. ASPLOS 2025; arXiv:2406.01566. https://arxiv.org/abs/2406.01566
    [18] 雷凯、黄硕康. 一种网络中数据内容的鉴授权方法和计算机可读存储介质. WO2021223097A1, 2021.
    [19] 雷凯、汪建平、刘斌、黄硕康. 一种网内资源的量纲测量方法、算力调度方法及存储介质. CN112003660A, 2020.
    [20] 雷凯、景晓军、李渝. 一种分层协同决策的网内资源调度方法及系统、存储介质. CN112346854A, 2021.
    [21] 雷凯、景晓军、李渝. 一种协调分布式的网内资源调度方法及系统、存储介质. CN112153153A, 2020.

  • Large-Scale Terminal Agentic Trajectory Generation from Dockerized Environments

    Large-Scale Terminal Agentic Trajectory Generation from Dockerized Environments

    1. 摘要(Abstract)

    本文研究的是面向终端环境的智能体训练数据构建问题。随着大模型智能体逐渐进入代码开发、系统运维、自动调试等真实任务,仅依赖静态文本数据已经难以训练出可靠的执行能力。终端任务的难点在于,模型不仅要理解指令,还要能在真实环境中执行命令、观察反馈、修复错误,并最终完成可验证的系统状态变化。因此,高质量的 terminal trajectories 对训练 agentic models 非常关键。

    现有数据构建方法主要存在两个瓶颈。第一是执行性问题,每个任务往往需要对应的依赖、文件系统状态和运行环境,缺少可运行环境的轨迹很难反映真实终端操作。第二是可验证性问题,不同任务的输出形式差异很大,不能简单用统一文本答案判断是否完成。现有方法要么能扩展任务多样性但缺少真实执行 grounding,要么提供可执行环境但规模有限,难以支撑大规模 agent 训练。

    针对这一问题,论文提出 TerminalTraj Pipeline,用于从真实 GitHub 仓库中自动构建 Docker 化执行环境、生成与环境对齐的终端任务,并通过可执行验证代码筛选成功轨迹。该流程首先利用模型评分筛选高质量仓库,再构建 Docker images,随后根据仓库中的 Markdown、Shell、代码文件和领域上下文生成任务实例,最后让 agent 在 Docker 环境中多轮交互,并用 pytest 等实例级验证代码确认任务是否真正完成。

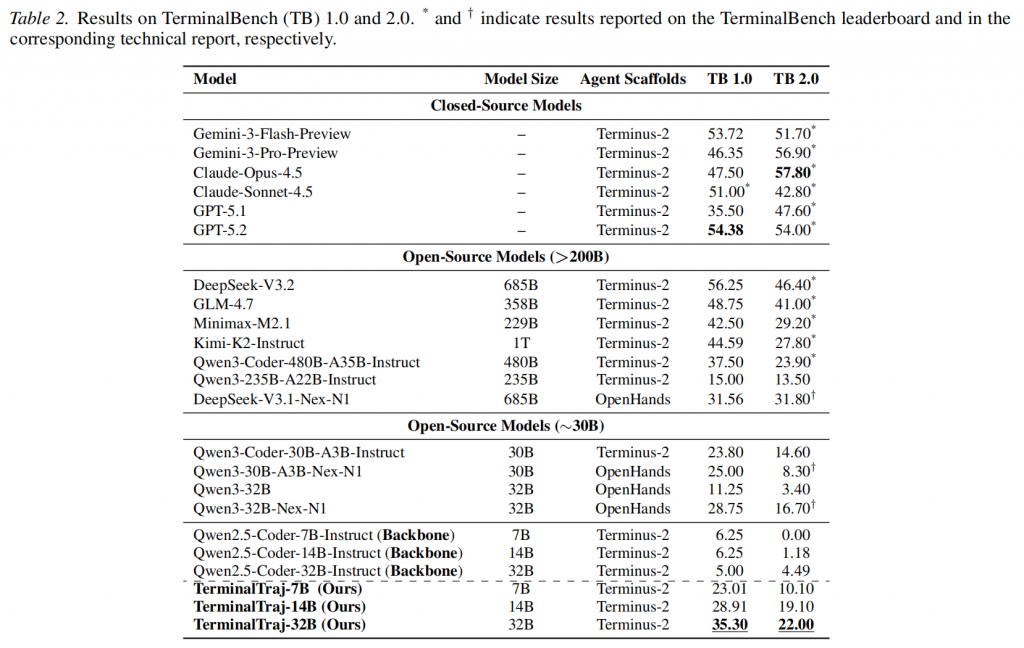
    最终,TerminalTraj 从 899,741 个 GitHub 仓库中构建出 32,325 个 Docker images,并生成 50,733 条 verified terminal trajectories,覆盖八种编程语言和八类专门领域。基于这些轨迹微调 Qwen2.5-Coder 系列模型后,模型在 TerminalBench 上取得明显提升,其中 TerminalTraj-32B 在 TB 1.0 上达到 35.30%,在 TB 2.0 上达到 22.00%,成为 100B 参数以下表现较强的 terminal agent 模型之一。更重要的是,该数据还能改善模型的 test-time scaling,TerminalTraj-32B 在 pass@16 下达到 63.75%。

    这篇论文的核心价值不只是提出一个新数据集,而是系统性回答了 terminal agent 训练中的一个基础问题,即如何大规模构建既能真实执行、又能可靠验证的长轨迹数据。它把 agent 数据构建从普通文本合成推进到执行环境驱动的数据工程,对后续代码智能体、系统智能体和自动化工作流训练都有较强参考意义。

    Large-Scale Terminal Agentic Trajectory Generation from Dockerized Environments插图

    2. 研究背景与问题动机(Introduction)

    近年来,AI agents 已经在代码修复、软件工程、工具调用和多轮推理任务中展现出较强能力,但许多评测和训练场景仍然简化了真实执行约束。真实终端任务并不是单纯回答问题,而是要求模型在命令行中读取文件、安装依赖、运行程序、处理错误输出,并根据环境反馈持续调整行动。TerminalBench 正是为了评估这种真实终端能力而提出的 benchmark。

    要提升 terminal agent 的能力,关键不只是设计更好的 agent scaffold,也不只是换更大的 base model,而是需要大量高质量的训练轨迹。这类轨迹必须包含完整的 long-horizon interaction,例如模型如何观察环境、选择命令、解释 stdout 和 stderr、修正失败步骤,并最终完成任务。相比普通代码补全或问答数据,terminal trajectory 更接近真实人类开发和系统操作过程,因此训练价值更高。

    但这类数据很难大规模构建。首先,每个任务都需要一个能够运行的环境。代码仓库里的文件本身并不等于可执行环境,缺少依赖、配置或 Dockerfile 时,agent 的操作就无法真实落地。其次,终端任务的答案并不一定是一个固定文本,很多任务的成功表现为文件被正确修改、服务被启动、配置生效或输出结果满足条件。因此,仅靠 LLM judge 或人工规则很难稳定判断任务是否真正完成。

    已有工作在这两个方面各有不足。Nex-N1 等方法可以生成较多任务和交互轨迹,但验证过程更依赖规则或 LLM judge,与真实执行环境结合不够紧密。SWE-bench 风格的数据集提供了更真实的仓库级执行环境,但环境数量和任务覆盖又比较有限。TerminalTraj 的动机正是解决这个矛盾,即在保持执行真实性和可验证性的同时,把环境和轨迹构建扩展到更大规模。

    3. 系统框架与整体设计(TerminalTraj Pipeline)

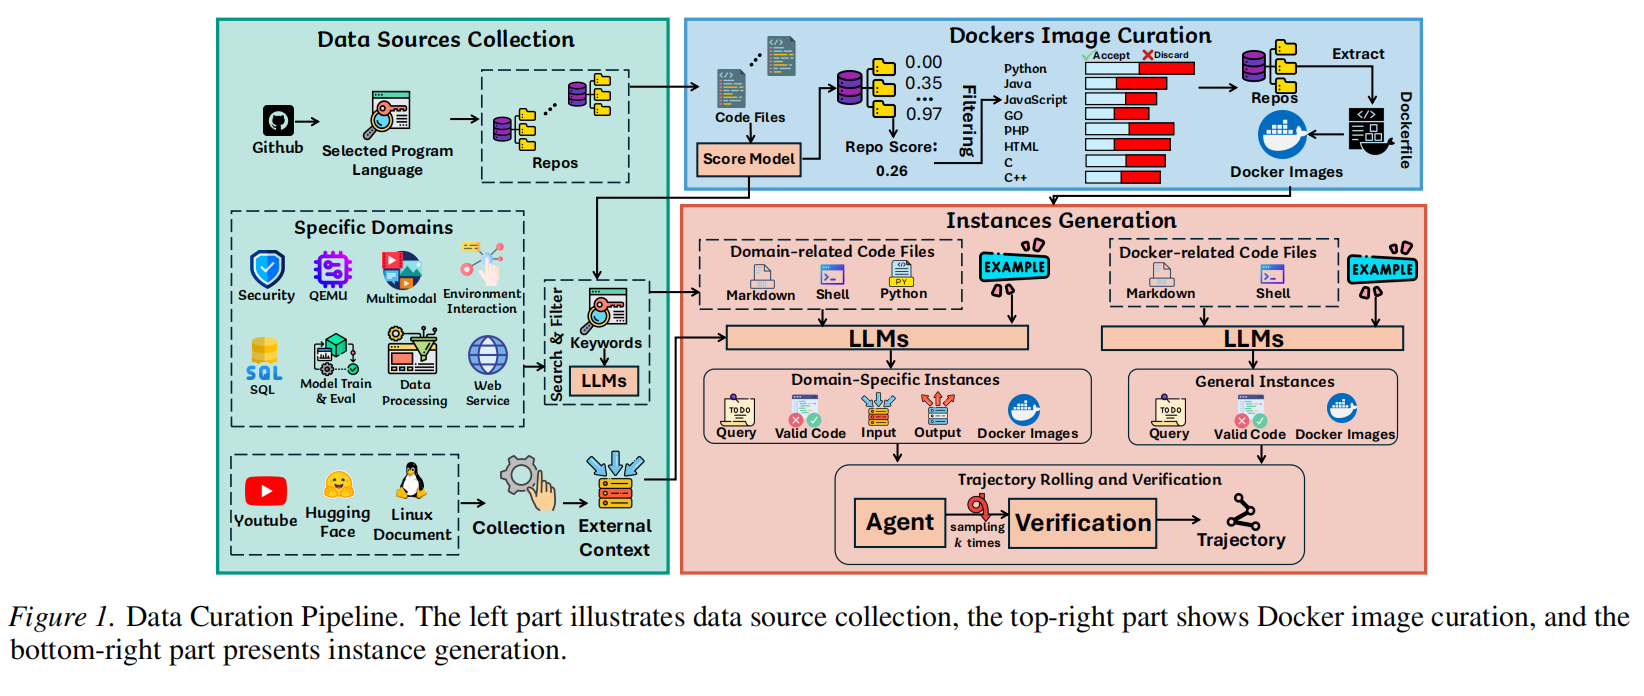
    TerminalTraj Pipeline 的整体流程可以分为三个部分。第一部分是数据源收集,作者从 GitHub 中收集八种主流编程语言相关的仓库,并补充文档、视频、图像、数据文件和网页服务等外部上下文。第二部分是 Docker image curation,系统通过模型评分筛选高质量仓库,并从仓库中提取或构建可运行的 Docker 环境。第三部分是 instance generation 和 trajectory verification,系统根据环境生成任务 query 和验证代码,再让 agent 在终端环境中执行任务,最后通过代码验证筛选成功轨迹。

    这个 pipeline 的关键思想是把真实开源仓库转化为可交互、可验证的 agent 训练环境。传统数据合成往往从任务描述出发,让大模型凭空生成问题和答案。TerminalTraj 则反过来,从可运行仓库和 Docker 环境出发,再生成与环境强绑定的任务。这种方式可以避免任务与环境脱节,使生成的问题必须依赖具体文件、依赖关系、命令工具和运行状态来解决。

    在数据源层面,作者并不只收集代码文件,而是有意识地保留与执行相关的信息,例如 Dockerfile、Shell 脚本、Markdown 文档和构建配置。对于领域任务,系统还额外引入外部上下文,例如 Hugging Face 数据、Linux 文档、图像、视频和网页链接等,使任务不局限于普通代码执行,而是覆盖数据处理、多模态、SQL、安全、QEMU、模型训练与评估、环境交互和 Web service 等不同场景。

    从整体设计看,TerminalTraj 的重点不是单纯扩大轨迹数量,而是把环境、任务、执行和验证四个环节串起来。每条最终保留下来的轨迹,都必须来自一个实际 Docker 环境,并通过对应验证代码确认成功。这使得数据本身更接近真实 terminal workflow,也更适合训练模型的实际操作能力。

    4. 核心方法(Docker 环境构建与任务生成)

    TerminalTraj 的第一项关键技术是 model-based repository scoring。原始 GitHub 仓库质量差异很大,很多仓库缺少完整依赖、构建配置或可执行入口。如果直接尝试构建 Docker image,会浪费大量计算资源。作者因此训练了一个 ScoreModel,根据代码文件的完整性和可执行性给每个文件打分,再汇总成仓库质量分数。低于阈值的仓库会被丢弃,从而提高后续 Docker 构建成功率。

    这一设计解决的是环境稀缺问题。过去一些方法依赖 stars、commits 等启发式指标筛选仓库,但这些指标不一定代表仓库适合构建可执行环境。TerminalTraj 改为直接预测仓库的执行质量,使筛选目标和最终任务构建目标更一致。实验也显示,高分仓库不仅 Docker build 成功率更高,生成出来的任务质量也更好。

    第二项关键技术是 Docker-aligned instance generation。系统不是随意生成任务,而是读取同一仓库中的 Markdown、Shell 和代码文件,让大模型反向推断什么样的用户需求会需要执行这些脚本或代码片段。这样生成的 query 与仓库环境天然对齐,agent 需要真正进入 Docker 环境中执行命令,才能完成任务。

    第三项关键技术是 executable validation code。与固定答案或 LLM 打分不同,TerminalTraj 为每个任务生成可执行验证逻辑,通常以 pytest suite 的形式出现。验证代码会检查最终环境状态,例如文件是否生成、配置是否正确、程序输出是否满足要求,而不是检查 agent 是否使用了某条固定命令。这种 state-based verification 更适合终端任务,因为真实任务通常允许多种解决路径,只要最终状态正确即可。

    在轨迹生成阶段,作者使用 Qwen3-Coder-480B 进行 trajectory rolling。agent 通过标准终端接口观察 stdout 和 stderr,执行命令,处理错误,并多轮修正计划。每个 query 会采样多次以增加轨迹多样性。只有最终通过验证代码的轨迹才会保留,因此数据质量主要由真实执行结果把关,而不是由模型自评决定。

    Large-Scale Terminal Agentic Trajectory Generation from Dockerized Environments插图1
    Large-Scale Terminal Agentic Trajectory Generation from Dockerized Environments插图2

    5. 数据集规模与质量分析(Dataset Analysis)

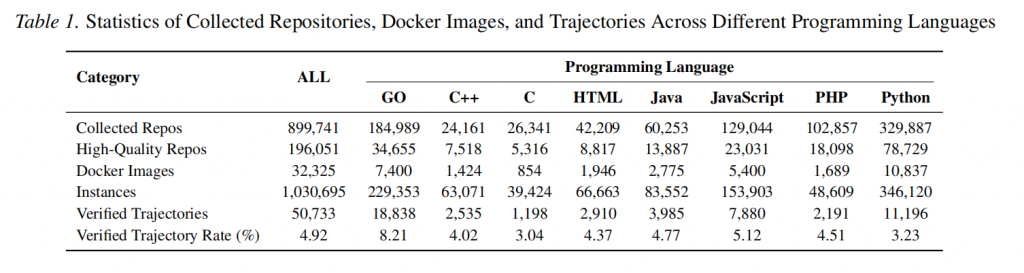
    TerminalTraj 的数据规模比较大。作者一共爬取 899,741 个 GitHub 仓库,覆盖 Go、C++、C、HTML、Java、JavaScript、PHP 和 Python 八种编程语言。经过质量筛选后,得到 196,051 个高质量仓库,并最终构建出 32,325 个 Docker images。随后,系统生成 1,030,695 个任务实例,并通过 agent 执行和验证筛选出 50,733 条 verified trajectories。

    从数据漏斗看,最终 verified trajectory rate 只有约 4.92%。这个比例看起来不高,但恰恰说明筛选标准比较严格。大量任务虽然可以生成,但 agent 未必能完成,或者最终状态不能通过验证代码。作者保留的并不是所有生成轨迹,而是真正在执行环境中完成任务的轨迹。因此,这个数据集的特点不是宽松收集,而是高精度过滤。

    作者还分析了 Docker image curation 的效率。随机选择带 Dockerfile 的仓库时,Docker build 成功率约为 9%。如果选择仓库分数高于 0.5 的样本,成功率提升到 19.5%,接近翻倍。论文实际采用更宽松的 0.2 阈值以保留语言和任务多样性,但仍能达到约 17% 的构建成功率。这说明 model-based filtering 在规模化环境构建中确实能节省计算成本。

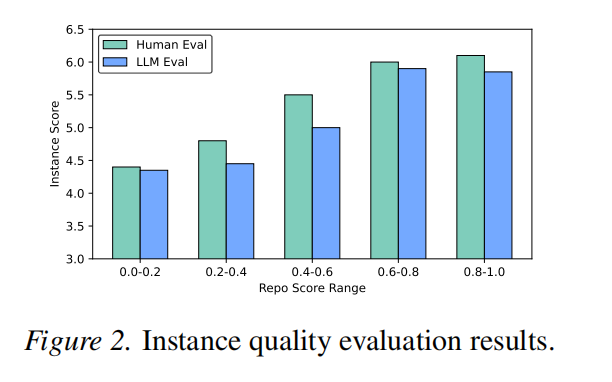
    实例质量方面,作者把任务按仓库分数分层抽样,并从 Task Soundness、Evaluability、Information Sufficiency 和 Behavioral Constrainedness 四个维度进行人工和 LLM 评价。结果显示,仓库分数越高,生成实例质量也越高。这说明仓库层面的可执行性信号能够传导到任务层面,从而同时改善环境构建和任务生成质量。

    6. 实验设置与模型训练(Experiment Setup)

    实验部分主要评估 TerminalTraj 数据对 terminal agent 能力的提升。作者选择 Qwen2.5-Coder 系列作为 backbone,包括 7B、14B 和 32B。选择 Qwen2.5-Coder 而不是 Qwen3-Coder 的原因是,Qwen2.5-Coder 发布时间早于 TerminalBench,可以降低 benchmark 污染风险。训练方式采用多轮监督微调,并使用 Megatron-LM 框架完成训练。

    评测基准是 TerminalBench 1.0 和 TerminalBench 2.0。这两个 benchmark 都用于测试智能体在真实终端环境中的任务完成能力。作者遵循 TerminalBench 的评测协议,并使用 Terminus-2 作为主要 agent scaffold。对于没有公开 TerminalBench 结果的模型,作者进行了四次独立运行,并报告平均性能和置信区间。

    对比模型覆盖面比较广,包括闭源模型、超大规模开源模型、30B 左右开源模型以及已有 agentic training 方法。闭源模型包括 Gemini、Claude 和 GPT 系列。开源模型包括 DeepSeek-V3.2、GLM-4.7、Kimi-K2、Qwen3-Coder 和 Nex-N1 系列。这样的设置可以同时比较 TerminalTraj 在同等规模、小于 100B 参数范围和超大模型之间的位置。

    从实验目的看,作者想证明的不只是 TerminalTraj 数据能让 Qwen2.5-Coder 变强,而是想说明执行环境驱动的数据构建比纯文本式或 judge-based 轨迹筛选更有效。因此,后续实验不仅看主结果,还看 pass@k scaling、领域消融、验证方式对比和与 Nex-N1 数据集的比较。

    Large-Scale Terminal Agentic Trajectory Generation from Dockerized Environments插图3

    7. 实验结果与性能分析(Results)

    主结果显示,TerminalTraj 数据带来了非常明显的提升。Qwen2.5-Coder 原始 backbone 在 TerminalBench 上表现较弱,7B 在 TB 1.0 上只有 6.25%,在 TB 2.0 上为 0.00%。经过 TerminalTraj 训练后,TerminalTraj-7B 提升到 23.01% 和 10.10%。14B 模型提升到 28.91% 和 19.10%。32B 模型提升到 35.30% 和 22.00%。这些结果说明,terminal trajectories 对模型的真实执行能力提升非常直接。

    TerminalTraj-32B 的表现尤其值得注意。它不仅超过 Qwen3-32B-Nex-N1,还超过部分更大规模的 open-source agentic models。在 TB 1.0 上,TerminalTraj-32B 比 Qwen3-32B-Nex-N1 高 6.55 个点,在 TB 2.0 上高 5.3 个点。而且 TerminalTraj 使用的是 Qwen2.5-Coder-32B 作为基础模型,backbone 并不比 Nex-N1 更强,这说明数据质量本身提供了主要增益。

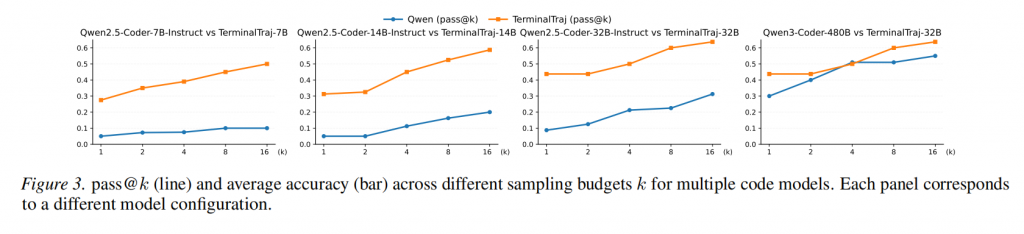
    Test-time scaling 结果也很关键。作者使用 pass@k 评估模型在采样更多候选轨迹时的性能变化。原始 Qwen2.5-Coder 系列 pass@k 曲线较平,说明额外采样不能有效转化为成功率提升。TerminalTraj 系列则表现出更陡的 scaling 曲线,随着 k 从 1 增加到 16,pass@k 提升约 20% 到 30%。其中 TerminalTraj-32B 在 pass@16 下达到 63.75%,并在多数 k 值下超过 Qwen3-Coder-480B。这说明执行 grounded 的训练轨迹不仅提升单次准确率,也提升了模型利用推理时计算预算的能力。

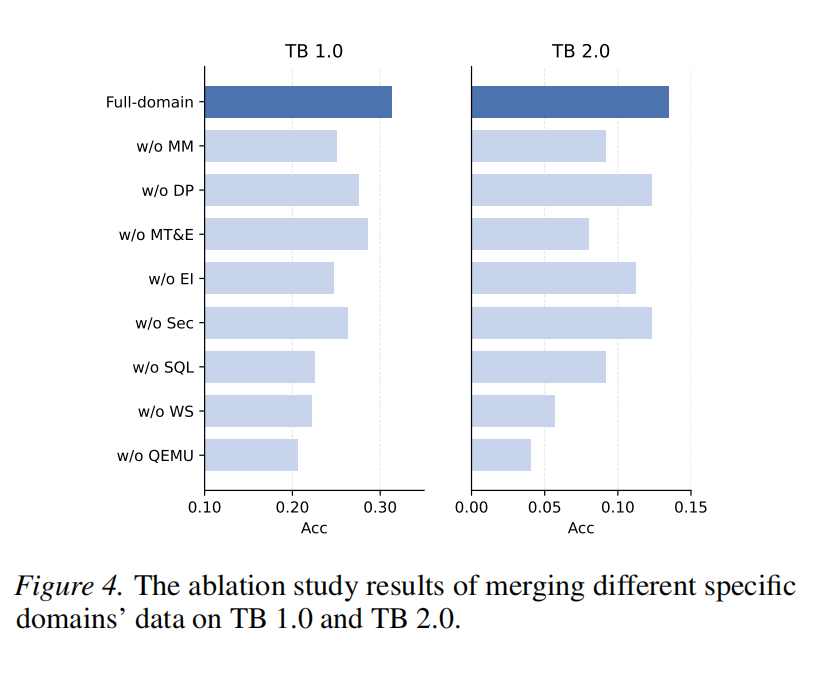
    领域消融实验进一步说明,多样化终端任务非常重要。作者从八个专门领域中各抽取 1,000 条轨迹,并配合 2,000 条 general-domain 轨迹形成训练集。移除任一领域都会导致性能下降,其中 Web Service 和 QEMU 的影响最大。去掉 Web Service 会让 TB 1.0 和 TB 2.0 分别下降 8.9% 和 7.4%,去掉 QEMU 则下降 9.7% 和 8.7%。这说明 terminal agent 需要大量不同工具、系统操作和环境交互数据,单一类型数据很难训练出稳健能力。

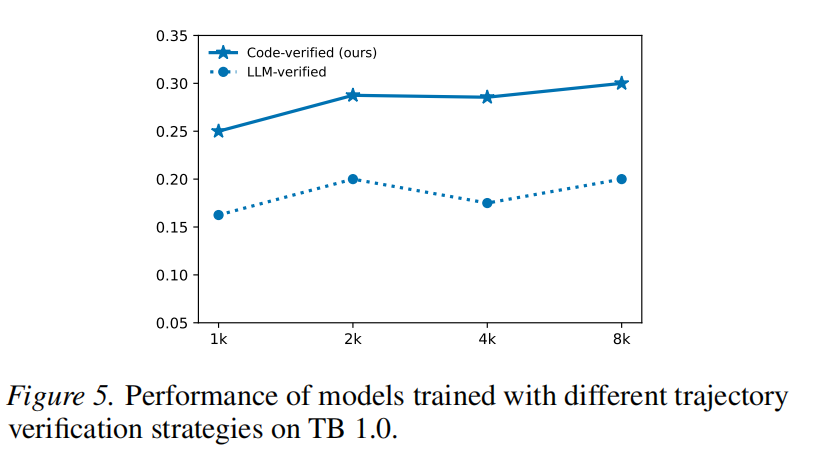
    验证方式对比也支持论文的核心观点。作者比较了 LLM-verified 和 Code-verified 两种轨迹筛选方式。结果显示,在 1K、2K、4K 和 8K 不同数据规模下,使用代码验证筛选的轨迹训练效果始终优于 LLM 判断筛选。尤其在小数据规模下,code-based verification 的优势更明显。这说明真实执行验证比模型自评更可靠,也再次证明了可验证性是 terminal trajectory 数据质量的核心。

    最后,作者将 TerminalTraj 与 Nex-N1 对比。尽管 TerminalTraj 的轨迹数量少于 Nex-N1,且使用的 backbone 更弱,但带来的性能增益更大。论文报告显示,TerminalTraj 在 TB 1.0 和 TB 2.0 上的提升幅度分别是 Nex-N1 的 1.7 倍和 1.3 倍。这说明对于 terminal agent 训练而言,轨迹数量不是唯一关键,环境多样性、执行真实性和验证质量同样重要。

    Large-Scale Terminal Agentic Trajectory Generation from Dockerized Environments插图4
    Large-Scale Terminal Agentic Trajectory Generation from Dockerized Environments插图5
    Large-Scale Terminal Agentic Trajectory Generation from Dockerized Environments插图6

    8. 贡献与结论(Conclusion)

    本文的主要贡献包括以下四点。

    第一,提出 TerminalTraj Pipeline,用于大规模构建多样化、可执行、可验证的 terminal agent trajectories。

    第二,引入 model-based repository scoring,将仓库筛选从启发式规则转为可学习的质量预测,提高 Docker image 构建效率,并支持持续扩展执行环境。

    第三,提出 Docker-aligned instance generation 和 code-based trajectory verification,使每个任务都与具体执行环境绑定,并通过实例级验证代码判断 agent 是否真正完成任务。

    第四,构建 32,325 个 Docker images 和 50,733 条 verified trajectories,并在 TerminalBench 上验证这些数据能显著提升 Qwen2.5-Coder 系列模型的终端任务能力和 test-time scaling 表现。

    这篇论文真正抓住的问题是,terminal agent 的训练瓶颈不只是模型大小,而是缺少足够多的真实执行环境和可靠验证信号。很多 agent 数据看起来像多轮轨迹,但如果没有实际执行和状态验证,就很难保证模型学到的是可迁移的操作能力。TerminalTraj 的价值就在于把数据构建建立在 Docker 环境和 executable validation 之上,使训练信号更接近真实终端任务。

    从研究意义看,这篇工作把 agentic data synthesis 推向了更工程化也更可信的方向。它说明未来训练可靠智能体时,仅靠文本任务、静态答案或 LLM judge 可能不够,必须让模型进入真实环境,并用程序化验证判断结果。对于代码智能体、科研自动化、系统维护和复杂 workflow agent 来说,这种执行 grounded 的数据构建思路都很有参考价值。

  • 面向大模型与智能体网络的知识驱动新型基础设施

    摘要 (Abstract)

    随着计算基础设施迈入大模型(LLM)与智能体互联网(IoA)时代,传统 TCP/IP 架构“尽力而为”的传输范式与“语义盲视”的固有缺陷,已成为制约全局算力协同与跨域可信交互的底层瓶颈。近期围绕 IPv8 草案的行业探讨,深刻暴露出单纯在应用层进行组件叠加已无法弥合物理网络与智能业务之间的结构性矛盾。针对泛在算力路由、网内动态确权及多维成本量化的演进需求,本文系统性地剖析了智能生态网络(Intelligent Eco Networking, IEN)这一新型基础设施演进范式。IEN 通过信息中心网络与区块链共识的深度融合,实现了控制面与数据面的高阶解耦。在数据面,提出了统一多维资源量纲的分层算力调度机制,并构建了基于零信任与去中心化标识(DID)的内容级网内动态鉴授权协议。在控制面,设计了基于“能力-意图-约束”的知识驱动闭环协同模型。结合大模型长上下文推理与多智能体全链路可信追踪两大典型场景的效能分析表明,IEN 能够有效打破传统网络的物理管道限制,为下一代价值互联网提供具备高弹性、算力感知与内生安全底座的中国方案。

    1. 引言

    1.1 传统网络架构的演进困境与瓶颈

    随着互联网应用由早期的简单文本传输过渡到高速流媒体,再到如今的泛在算力服务与分布式智能体交互,底层互联网基础设施的设计缺陷日益显现。传统TCP/IP网络架构以“主机-地址-链路”为核心拓扑进行数据包转发,采取“尽力而为(Best-effort)”的传输范式。这种设计将网络层抽象为单一的管道,对传输的内容语义、参与主体的身份可信度以及计算/存储资源的开销状况缺乏感知能力。

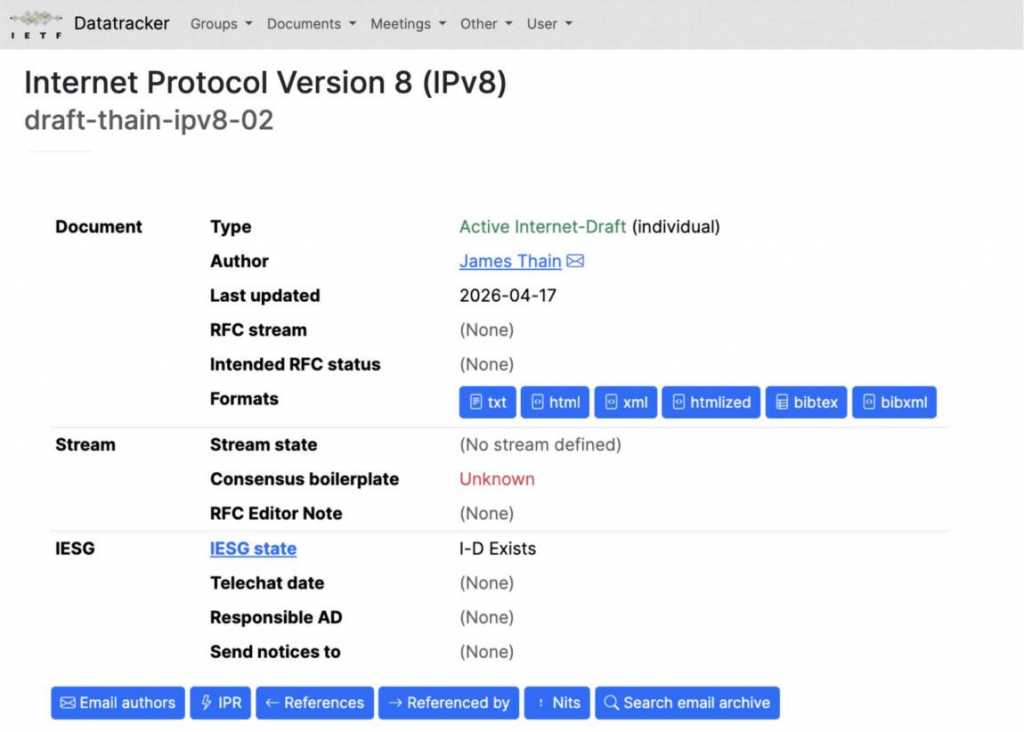
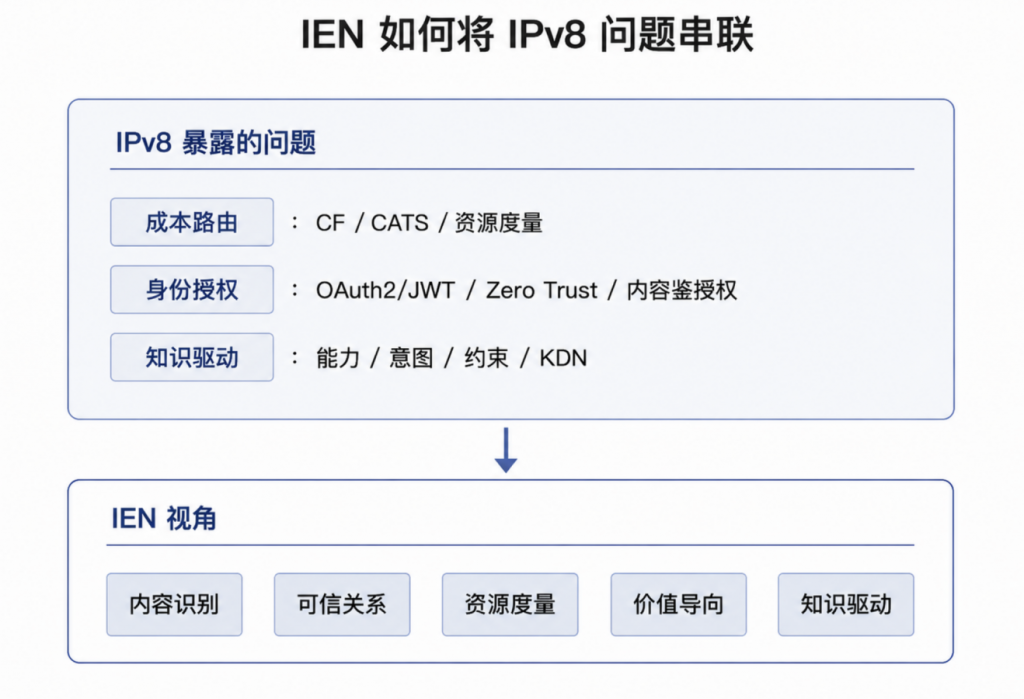
    近期,业界围绕IETF Internet-Draft《Internet Protocol Version8(IPv8)》(draft-thain-ipv8)展开了广泛讨论。尽管该草案尚属个人提交的非标准化演进探索,其核心价值并非在于提出了一个新的协议版本号,而在于其集中暴露出传统IP网络在演进过程中的深层痛点。该草案尝试将边界网关协议演进(BGP8)、路由注册确权、身份认证(OAuth2/JWT)、多维成本因子路由(CF routing)以及网络状态监测(NetLog8)等机制强行整合至同一网络管理图谱中[1]。

    面向大模型与智能体网络的知识驱动新型基础设施插图

    这一尝试深刻反映出一种历史性趋势,未来网络面临的交互主体已不再仅仅是物理主机与拓扑地址,而是大量的内容数据、算力服务、大模型调用及复杂的智能体行为。如果网络层的抽象依旧停留在“将IP报文从拓扑源地址送达目的地址”的低维阶段,那么涉及内容寻址、动态权限校验、全网计算资源匹配及服务成本量化的复杂问题,就必须被推向应用层、平台层或运维层进行重复且碎片化的处理。这种“网络层盲目、应用层打补丁”的烟囱式架构,必然引发各层级之间高昂的开销振荡与优化冲突,极大降低了整网系统的运转效率与可扩展性。

    1.2 泛在大模型与智能体网络带来的新挑战

    进入大模型(LLM)与智能体互联网(Internet of Agents,IoA)时代后,传统网络架构的这种“语义与资源盲视”缺陷被进一步推向了台前。网络基础设施不仅要承担高带宽的数据搬运任务,还必须深度参与到计算与服务调度的闭环中。具体而言,大模型和智能体网络对新型基础设施提出了三方面前所未有的严苛挑战。

    • 多维算力资源感知的路由挑战:在大模型分布式推理场景下,请求路由决策已远非传统的链路时延(RTT)或丢包率所能决定。用户的连续对话伴随着状态化上下文(KVCache)的生成。如前沿LLMServing系统(如Mooncake)所示,若网络层缺乏对节点算力队列、GPU运行状态及已有KVCache缓存位置的精确感知,盲目按照最短网络路径转发请求,将导致目的节点重复计算或产生高昂的跨节点数据传输开销[8,10,12,13]。因此,传统路由的成本度量必须从单一的“链路指标”跨越到包含计算能效、存储状态、服务延迟在内的“多维资源成本”。
    • 读写场景下网内动态确权与可信追踪挑战:当前的智能体(Agent)正加速从只读(Read-only)的资料检索转向读写(Read-write)的复杂工作流协同,能够代表用户调用各类工具、访问异构数据并执行状态修改。在此背景下,传统的基于网络边界防火墙或应用层单次静态登录的认证范式彻底失效。由于内容流、服务流在网络中高度动态地被缓存、复用与转发,网络层必须引入零信任(Zero Trust)理念[12]与网内(In-network)细粒度鉴授权机制。当内容节点命中请求或智能体跨域调用下游工具时,网络需要实时校验请求主体的身份可信度与授权责任链,防止敏感数据的越权访问与行为抵赖。
    • 面向复杂业务意图的知识化控制挑战:在庞大的智能生态中,不同业务任务对网络基础设施的内在约束各异。普通查询任务注重极低时延,写操作严控权限与审计,而大模型分布式训练同步则对RoCE网络的拥塞控制、吞吐量和稳定性有极端要求。传统控制面因无法识别任务意图,只能执行单一的物理转发策略。未来的网络控制面必须转变为“知识驱动”,能够综合分析节点的能力状态、业务的真实意图及策略边界的多重约束,在路由与资源调度时实现多目标的最优匹配。

    1.3 本文探讨的核心视点与IEN融合框架

    针对上述挑战,单纯在传统IP协议栈上进行零碎的“打补丁式”修正(如IPv8草案所设想的组件简单叠加)难以从根本上解决跨层优化的结构性矛盾。为此,本文立足于智能生态网络长期的研究主线,探讨一种将内容识别、可信关系、资源度量、价值导向与知识驱动[3]融为一体的新型网络基础设施演进视角。本文并非旨在提出单一的新型协议,而是系统性地梳理并融合以下三大核心视点。

    • 从链路路由向多维资源分层调度的演进视点:探讨如何将计算能效、内存状态、传输延迟等异构资源指标统一纳入网络节点的算力量纲评估体系[7]。论述IEN基于分层协同决策的网内资源调度机制与IETF CATS[8]、多维成本路由(CF routing)[1]等前沿理念的互补与融合,以应对大模型与泛在计算感知的网络路由需求。
    • 从边界防护向网内内容级动态确权的演进视点:结合零信任架构理念,剖析IEN在数据内容鉴授权方面的交互流程设计[5]。探讨在内容被广泛缓存与复用的高度动态环境中,如何实现伴随内容请求、流转与智能体跨域交互的全链路可信追踪与授权责任确认。
    • 从单一可达性向“能力-意图-约束”知识驱动的演进视点:基于知识定义网络(KDN)的基本逻辑,论述IEN如何将服务能力感知、业务语义意图识别和策略边界约束引入网络控制面。探讨在多智能体协同与大模型推理场景下,资源状态与闭环调度如何赋能底层网络架构,实现知识驱动的系统最优化调度。

    2. 下一代互联网演进的动因与需求分析

    新型网络基础设施的演进并非源于纯粹的理论推演,而是由日益突出的上层应用瓶颈所驱动。随着大模型(LLM)与智能体(Agent)等计算密集型、交互密集型业务的爆发,传统IP网络的“语义盲视”与“资源盲视”缺陷日益凸显。本节将从算力路由、动态确权及成本量化三个维度,深入剖析下一代互联网面临的核心技术痛点与演进需求。

    2.1 基于大模型推理与训练的算力路由需求

    传统互联网的尽力而为(Best-Effort)模型主要解决主机的拓扑可达性问题,其核心假设是“网络仅负责数据搬运,端系统负责计算与状态管理”。然而,在大模型时代,这一假设已成为制约系统整体效能的瓶颈。

    在大模型分布式推理场景下,长上下文的交互高度依赖于历史状态(如KVCache)的驻留与复用。当前沿的LLM服务系统(例如Mooncake架构)在处理连续对话请求时,若底层网络仍采用传统的盲目负载均衡或最短路径路由(最短RTT),极易将请求调度至未命中缓存的算力节点。这不仅会导致目标节点算力的重复损耗,还将引发巨大的跨节点数据传输延迟与GPU队列排队成本。

    在大模型分布式训练侧,Meta等机构在利用RoCE(RDMA over Converged Ethernet)网络支撑大规模AI训练的工程实践中表明[14],单纯增加GPU数量已无法实现算力的线性扩展,网络层面的带宽瓶颈、拥塞控制与拓扑可靠性已直接成为训练效能的决定性因素。因此,未来的网络基础设施亟需具备“算力感知(Computing-Aware)”能力,使得请求的转发能够与节点的算力余量、内存状态及服务质量目标(SLO)实现端到端的协同调度。

    2.2 智能体协作场景下的动态信任边界与网内确权

    随着智能体互联网(Internet of Agents,IoA)的快速演进,网络交互的主体正发生根本性的范式转移。早期的Agentic AI主要停留在只读(Read-only)的资料检索层级。而随着应用场景的深入,智能体开始进入读写(Read-write)的复杂工作流[11],具备了代表用户自动发现服务、调用跨域工具、修改系统状态的能力。

    在这种高度自治与跨域协作的场景中,传统的信任边界模型面临失效。过去依赖网络边界防火墙或应用层“单次登录验证”的静态安全机制,无法应对内容与服务在网内被频繁缓存、复用与接力调用的动态特性。借鉴零信任架构的核心理念,未来网络不可再默认内部拓扑天然可信,而必须围绕数据与资源实施持续验证。当智能体在网络中发起一次具有状态修改属性的操作时,网络基础设施需要有能力沿着数据流向,追溯该请求的发起者身份、校验其授权范围(鉴权),并生成不可篡改的责任链记录(确权)。这就要求认证与授权机制必须从应用层入口下沉,转变为伴随数据与服务流转的“网内动态确权(In-network Authorization)”。

    2.3 传统路由成本评估的维度缺失与多维量化挑战

    无论是应对大模型算力协同还是智能体的可信交互,底层网络在进行路由与控制决策时,都必须依赖更精确、更多维的代价度量体系。然而,当前IP网络在评估路径质量时,指标高度单一(主要局限于网络时延、跳数及丢包率),缺乏对真实业务开销的刻画。

    近期引发热议的IPv8草案中提出了成本因子路由(CF routing)的设想,试图将时延、带宽、链路稳定性及自定义成本策略纳入累计代价的计算模型中。与之类似,IETF的CATS(Computing-Aware Traffic Steering)工作组也正致力于研究如何将网络状态与计算服务状态进行联合评估[8],以实现流量引导的全局最优化。结合上述研究趋势可以发现,下一代网络必须建立涵盖多层级的成本量纲模型。

    • 网络层成本:如传统RTT、吞吐量与链路拥塞状态。
    • 服务层成本:如目标服务实例的存活状态、排队长度与并发处理能力。
    • 算力/任务层成本:如边缘节点处理与中心集群回源对全局计算资源的消耗差异。

    综上所述,成本路由的核心挑战并非简单增加几个评估字段,而是网络系统如何感知异构资源的实时状态,并将其统一转化为可度量的数学量纲。这正是单一维度的协议修补无法解决的问题,从而构成了本文提出IEN系统性融合架构的核心动因。

    3. 智能生态网络(IEN)体系架构设计

    针对传统IP网络在算力感知、动态确权及多维开销度量等方面的结构性缺失,单纯依赖应用层“补丁”或单一网络协议字段的修补(如IPv8草案中的组件叠加)已无法从根本上消除跨层优化的开销振荡。为此,IEN提供了一种系统性的网络基础设施演进蓝图。IEN不仅是一种新型的网络协议,更是一种将内容识别、可信关系、资源度量、价值导向与知识驱动深度融合的体系架构[6]。本节将系统阐述IEN的演进范式、平面重构设计以及闭环控制模型。

    3.1 架构演进范式与总览

    传统IP网络采用“以主机为中心(Host-Centric)”的演进范式,将网络拓扑地址作为转发与路由的核心依据。这种设计导致网络层无法感知传输内容的语义,亦无法评估底层的计算与存储开销。IEN则实现了向“以内容为中心(Content-Centric)”和“计算与传输融合(In-Network Computing)”的范式转移。

    IEN的总体架构基于信息中心网络(ICN/NDN)、分布式账本(区块链)以及人工智能技术的深度融合,形成“链网融合”的新型基础设施体系。架构自底向上解耦为三个核心层面。

    • 语义原生与数据转发层(数据面):摒弃物理拓扑地址寻址,采用层次化命名的数据块作为网络的基本传输单元,实现语义原生的内容识别与网内缓存命中。
    • 分布式可信与价值流转层(链网融合面):引入去中心化标识(DID)与分布式账本技术,将网络节点、数据要素和智能体行为转化为可信的数字资产,为其提供全局一致的身份确权、权限管理和价值度量底座。
    • 知识驱动与协同调度层(控制面):作为网络的“中枢大脑”,全面搜集网内拓扑、节点算力状态及任务意图,通过机器学习与决策算法实施跨全网的多目标最优化资源调度。

    3.2 控制面与数据面的深度解耦与重构

    在IEN体系结构中,控制面与数据面经历了超越传统SDN(软件定义网络)的深层次重构。传统SDN仅实现了控制逻辑(流表下发)与转发行为的分离,而IEN则进一步实现了内容语义、信任关系与资源状态在底层网络架构中的统一抽象与深度解耦。

    3.2.1 数据面的语义原生与内生安全

    传统网络的安全机制(如TLS/SSL)是建立在通道可信(Pipe Security)的基础上的,一旦数据离开传输通道或被网内节点缓存,其可信度便无法验证。IEN数据面基于信息中心网络设计,采用“面向内容本身的安全(Object Security)”机制。每一块数据内容均携带层次化签名与访问权限约束。内容请求(Interest包)与数据响应(Data包)均通过名字进行匹配,数据包内置数字签名。网络节点和智能体在转发或复用缓存内容时,无需依赖最外层的应用入口登录,即可直接在网内完成内容级的动态鉴权。数据面不仅负责数据块的转发,还将节点的计算服务(如大模型推理功能函数)和存储资源(如KVCache缓存)统一抽象为可寻址的网络资源,打破了“传输”与“计算”的边界。

    3.2.2 全局网络问题图谱的控制面抽象

    控制面不再仅仅维护一张拓扑拓扑表,而是构建了一个集成了“内容识别-可信关系-资源度量”的多维网络问题图谱。控制面通过将上层智能体的业务意图转化为图谱中的约束条件,将底层的链路带宽、时延、计算队列、存储空间统一作为图谱中的边权与节点状态,从而在底层网络路由时,能够直接求解出最优的服务协同路径。

    3.3 知识驱动与价值导向的闭环控制模型

    IEN的核心控制哲学可以概括为“知识驱动(Knowledge-Driven)”与“价值导向(Value-Oriented)”的闭环协同[3]。这两者并非抽象的概念宣称,而是有着明确的技术内涵与状态流转机制。

    3.3.1 价值导向的资源量化与共识激励

    在大模型基础设施与多智能体协作场景中,算力消耗与数据复用必须具备明确的成本账本。IEN的“价值导向”机制依托于链网融合架构,通过去中心化标识(DID)和网络非同质化数据要素的融合,将节点的闲置GPU算力、内存空间以及网内缓存的数据资产进行精细化量纲度量与产权化。当一个大模型推理请求在边缘节点命中KVCache或被调度至特定算力集群时,底层账本能够自动记录该次服务对全局资源的占用,为跨域的资源共享、智能体行为审计及成本分摊提供不可篡改的共识数据。

    3.3.2 知识驱动的“能力-意图-约束”自适应闭环

    基于知识定义网络(KDN)的基本逻辑,IEN控制面将机器学习和策略控制深度结合,形成了一个面向任务语义的智能闭环。

    • 能力感知(Capability Perception):控制面持续监测并推演全网节点的服务能力,包括计算资源量纲(CPU/GPU负载、排队时延)和存储资源状态(KVCache命中概率)。
    • 意图识别(Intent Recognition):网络层能够解析上层任务的类型(如区分低时延的短文本查询、高吞吐的大模型分布式训练同步或高动态的智能体跨域写操作)。
    • 约束求解(Constraint Solving):结合任务的时延SLO、安全边界及预算上限,控制面在线实时求解多目标优化问题,将策略动态注入数据面。

    通过这种知识与价值的双驱闭环,IEN成功将底层网络的物理调度能力与上层大模型/智能体的业务逻辑无缝缝合,为应对未来更高复杂度的泛在智能交互提供了高弹性的底层架构范式。

    4. 基于 IPv8 关联背景的 IEN 关键机制解剖  

    近期引发广泛讨论的 IPv8 草案(draft-thain-ipv8),其本质价值在于将原本散落在网络各个层级的边缘问题(路由成本因子、身份认证、管理平面等)强行整合到了一个统一的网络话语体系中。这种组件的强行叠加,恰恰映射出现代网络在面对大模型算力调度与智能体(Agent)可信交互时,底层机制的捉襟见肘。本节结合原始文献的内核,深入解剖智能生态网络(IEN)如何基于“链网融合”与“内容中心”的思维范式,对成本、认证和知识驱动三大核心演进支柱进行底层重构与交账。

    面向大模型与智能体网络的知识驱动新型基础设施插图1

    4.1 网内算力与传输联合度量

    在传统 IP 网络或 IPv8 草案所设想的“成本因子路由(CF routing)”中,成本的度量依然局限于网络层本身的物理指标,如链路时延(RTT)、带宽、丢包率以及管理策略开销。即便当前 IETF CATS(算力感知网络)工作组尝试将计算状态引入流量引导,由于底层 IP 架构缺乏对传输语义的感知,其决策往往也是应用层与网络层相互割裂的“两阶段”拼接。

    IEN 认为,在大模型分布式推理与泛在智算时代,“网络成本”的内涵已经发生了根本性的升维。它必须转变为一种涵盖“传输、计算、存储”的多维联合代价函数。 以大模型长上下文推理场景为例,用户的连续对话请求伴随着 KV Cache 状态的动态驻留。此时,盲目追求网络路径的最短 RTT 极易引发高昂的“冷节点重新计算成本”,而强行拉回中心智算集群,又会产生巨大的“跨网带宽挤占与数据回源成本”。

    IEN 基于信息中心网络(ICN)原生路由机制,在底层建立了异构资源联合开销评估模型。网络路由决策不再仅仅算链路多快,而是将目的节点的功能函数可用性、当前 GPU 队列排队时延以及 KV Cache 缓存命中率统一转化为可度量的成本量纲。通过这种多维成本因子的底层融合,IEN 能够在网络转发层面直接权衡“在近端重新计算”与“去远端命中缓存”的综合能效比,从根本上化解了传统网络因“资源盲视”导致的算力孤岛与跨层振荡难题。

    4.2 数据对象原生与网内动态确权

    IPv8 草案在处理安全问题时,尝试将应用层的 OAuth2、JWT(JSON Web Token)等认证组件直接“下沉”打包进网络协议栈中。这一做法虽然看到了网络层身份缺失的痛点,但其实质依然属于“在管道上打补丁”。由于其认证机制是绑定在通信端点(主机地址)之间的,一旦数据内容脱离了原始服务器的物理边界、在网内发生高频缓存与二次分发,这种基于“通道安全”的信任链条就会瞬间瓦解。

    在多智能体高自治交互的今天,Agent 正加速从“只读”走向“读写”的跨域协作,调用各类 API 并执行状态修改。如果安全机制依然依赖传统的边界防火墙或单点应用层登录,极易引发越权访问和全链路审计缺失。

    IEN 引入零信任架构资产,将认证范式从传统的“通道安全”彻底推向了“对象安全”与“数据确权”的全新维度。在 IEN 数据面中,每一个被传输的数据块和智能体请求都原生地内嵌了去中心化标识和多层层次化数字签名。这意味着数据本身即具备“可信度”,无需依赖最外层的服务器通道。

    当智能体的写操作或内容命中请求流经 IEN 缓存节点时,底层路由器能够沿着数据流向,在网内实时校验请求主体的身份合法性与授权链。这种伴随内容流转而触发的动态确权机制,为高度自治的 AI 协同网络拉起了一条不可篡改、全链路可追溯的内生安全边界。

    4.3 面向“能力-意图-约束”的知识驱动

    长久以来,“知识驱动网络”在传统 IP 语境下往往沦为一种概念化的宣称。传统路由协议(如 BGP、OSPF)的核心逻辑是机械式的规则匹配与静态拓扑收敛。即便引入了所谓的自动化运维或浅层的机器学习,由于控制面无法感知业务层的真实语义与意图,它依然只能在物理管道的转发规则里打转。

    而在 IEN 的设计哲学中,知识驱动是底层架构能够动态响应大模型与智能体复杂业务约束的智能中枢。 IEN 结合知识定义网络的基本逻辑,将网络控制面重塑为一个能够持续运转、自我演进的“智能闭环系统”。这一系统的运行核心可以提炼为对“能力-意图-约束”多维网络图谱的在线求解。控制面通过网络遥测技术,实时感知全网节点的多维资源水位(网络拓扑、GPU 负载、KV Cache 分布)。网络层能够深度解析上层业务的意图。例如,自动识别当前的流量属于注重极低延迟的长上下文对话,还是严控访问权限的智能体跨域写操作。结合多方协同策略边界(资源合规性、用户预算限制等)。

    控制面的智能大脑在接收到任务意图后,能够自适应地求解多目标优化约束问题,动态调整数据面的多维资源路由权重,将流量精准、按需地引导至全局最优解。这种知识驱动的闭环,让基础设施彻底告别了“盲目管道”的宿命,完成了网络控制平面向可编程、自适应、语义化的历史性跃升。

    5. 总结与展望(Conclusion)

    纵观互联网半个多世纪的演进史,传统TCP/IP架构凭借其极致简洁的“尽力而为(Best-effort)”连通性模型,成功支撑了从极客网络到全球消费级移动互联网的跨越。然而,当底层算力基础设施步入大模型(LLM)时代,当上层应用生态演进至高度自治的多智能体网络(IoA)时,网络层“语义盲视”与“资源盲视”的历史局限性已成为制约系统整体效能的最大瓶颈。近期业界关于IPv8草案的讨论,其本质正是这种底层焦虑的集中投射——强行在应用层和平台层进行无尽的“打补丁”,已无法弥合物理网络与智能业务之间的巨大鸿沟。

    本文系统性地回应了这一时代诉求,立足于智能生态网络(IEN)架构,提出了一种从根本上打破封闭体系的新型基础设施演进范式。IEN并非对现有协议的简单修补,而是通过控制面与数据面的深度重构,完成了三大核心机制的跨越。

    在成本与路由维度,提出了多维资源统一量纲模型与分层协同的算力路由,实现了网络从“尽力搬运”向“算力感知与全局最优化调度”的蜕变。在认证与安全维度,结合零信任理念,构建了基于去中心化标识(DID)的内容级网内动态确权协议,为多智能体跨域协作确立了坚实的责任审计边界。在控制与管理维度,建立了“能力-意图-约束”闭环的知识化网络协同优化框架,使底层网络真正成为具备自我演进能力的智能底座。

    参考资料

    [1] J. Thain, Internet Protocol Version 8 (IPv8), Internet-Draft draft-thain-ipv8, IETF Datatracker, 2026. https://datatracker.ietf.org/doc/draft-thain-ipv8/

    [2] IANA, IP Version Numbers. https://www.iana.org/assignments/version-numbers/version-numbers.xhtml

    [3] 雷凯、黄硕康、方俊杰、黄济乐、谢莹莹、彭博, Intelligent Eco Networking (IEN): Knowledge-Driven and Value-Oriented Future Internet Infrastructure, Journal of Applied Sciences, 2020. DOI: 10.3969/j.issn.0255-8297.2020.01.012

    [4] ICNLab, 智能生态网络 IEN 2022:面向 Web3.0 的内容中心链网融合架构, 2022. https://www.icnlab.cn/?p=6505

    [5] 雷凯、黄硕康, 一种网络中数据内容的鉴授权方法和计算机可读存储介质, WO2021223097A1, 2021.

    [6] 雷凯、汪建平、刘斌、黄硕康, 一种网内资源的量纲测量方法、算力调度方法及存储介质, CN112003660A, 2020.

    [7] 雷凯、景晓军、李渝, 一种分层协同决策的网内资源调度方法及系统、存储介质, CN112346854A, 2021.

    [8] Cheng Li et al., A Framework for Computing-Aware Traffic Steering (CATS), IETF Internet-Draft draft-ietf-cats-framework-24, RFC Editor Queue, 2026. https://datatracker.ietf.org/doc/draft-ietf-cats-framework/

    [9] Yuntao Wang, Shaolong Guo, Yanghe Pan, Zhou Su, Fahao Chen, Tom H. Luan, Peng Li, Jiawen Kang, Dusit Niyato, Internet of Agents: Fundamentals, Applications, and Challenges, arXiv, 2025. https://arxiv.org/abs/2505.07176

    [10] Ruoyu Qin, Zheming Li, Weiran He, Mingxing Zhang, Yongwei Wu, Weimin Zheng, Xinran Xu, Mooncake: A KVCache-centric Disaggregated Architecture for LLM Serving, arXiv, 2024. https://arxiv.org/abs/2407.00079

    [11] Developing.dev, Turing Award Winner: Postgres, Disagreeing with Google, Future Problems | Mike Stonebraker, 2026. https://www.developing.dev/p/turing-award-winner-postgres-disagreeing

    [12] Scott Rose, Oliver Borchert, Stu Mitchell, Sean Connelly, Zero Trust Architecture, NIST SP 800-207, 2020. https://doi.org/10.6028/NIST.SP.800-207

    [13] Albert Mestres et al., Knowledge-Defined Networking, ACM SIGCOMM Computer Communication Review, 2017. DOI: https://doi.org/10.1145/3138808.3138810

    [14] Adi Gangidi, James Hongyi Zeng, RoCE Networks for Distributed AI Training at Scale, Meta Engineering, 2024. https://engineering.fb.com/2024/08/05/data-center-engineering/roce-network-distributed-ai-training-at-scale/

  • Self-evolving LLM Agents with In-distribution Optimization

    Self-evolving LLM Agents with In-distribution Optimization

    1. 摘要(Abstract)

    本文研究的是长程交互型 LLM Agent 的训练问题,核心关注点是稀疏延迟奖励下的贡献归因。随着大语言模型从静态文本生成逐渐走向环境交互,LLM Agent 需要在网页购物、虚拟实验、家居任务等复杂环境中进行连续决策。然而,这类任务通常只有在整个 episode 结束后才给出最终奖励,中间步骤缺少明确监督,导致模型很难判断哪一步真正推动了任务成功,哪一步造成了失败。

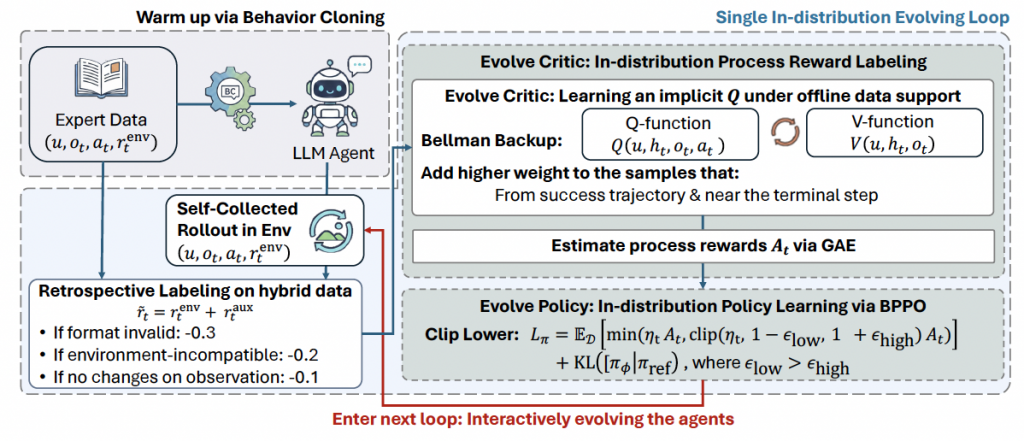
    针对这一问题,论文提出 Q-Evolve,一种面向 LLM Agent 的自进化训练框架。它的核心思想是将过程奖励自动标注和策略学习统一到同一个 in-distribution learning loop 中。具体而言,Q-Evolve 首先使用专家轨迹对模型进行行为克隆预热,然后收集模型自身与环境交互产生的轨迹,并将专家数据和自生成数据合并成 hybrid offline dataset。在此基础上,框架训练一个 in-distribution critic,通过 weighted Implicit Q-Learning 将终局奖励向前传播,得到更可靠的 step-wise process rewards。最后,模型再利用这些过程奖励,通过 behavior-proximal policy optimization 更新策略。

    这篇论文的关键创新不在于简单增加一个奖励模型,而在于强调过程奖励必须在同一数据分布内被生成和使用。作者指出,传统 PRM 方法容易出现 distribution shift,即奖励模型训练时看到的数据和策略优化时产生的数据不一致,导致中间反馈失真。Q-Evolve 则通过让 policy、critic 和 dataset 在同一闭环中共同演化,减少这种分布错位,使 agent 能够稳定自我改进。

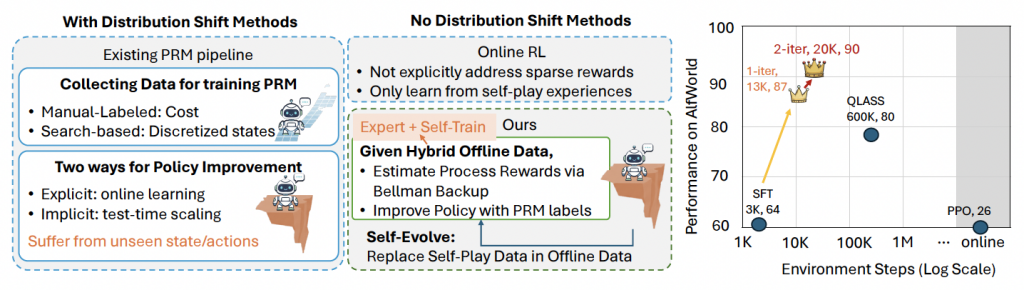
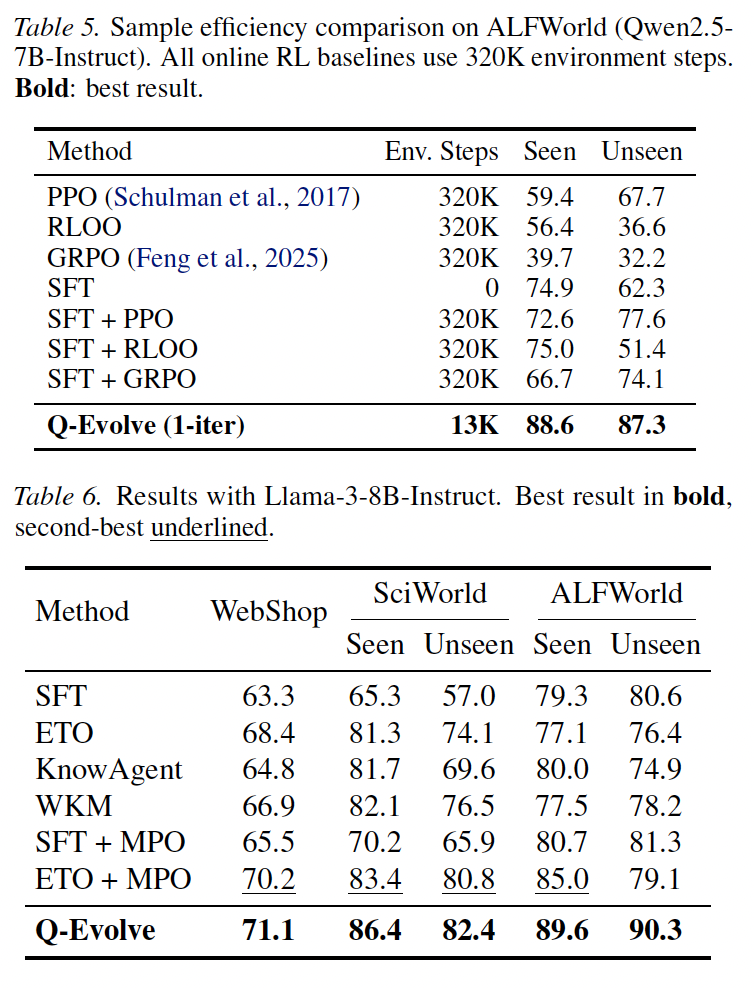
    实验方面,论文在 AlfWorld、WebShop 和 ScienceWorld 三个长程交互任务上进行评估。结果显示,Q-Evolve 在总体性能、样本效率和泛化能力上均优于多种强基线方法。尤其在 AlfWorld 上,Q-Evolve 用约 13K 环境步数就超过了多个使用 320K 环境步数的 online RL 方法,体现出较强的样本效率。整体来看,该工作为 LLM Agent 的长期决策训练提供了一种较稳健的自进化路径,也进一步说明过程级监督和策略学习需要放在统一分布中共同设计。

    Self-evolving LLM Agents with In-distribution Optimization插图

    2. 研究背景与问题动机(Introduction)

    近年来,大语言模型已经不再只是文本生成器,而是逐渐成为交互式 agent 的控制器。LLM Agent 可以通过自然语言进行推理、规划和环境交互,因此被用于导航、游戏、网页操作、机器人控制等任务。与普通问答不同,交互式任务要求模型连续观察环境、选择动作、接收反馈,并在多个步骤后完成目标。这类任务更接近真实世界的智能体问题,也更能体现大模型从语言能力走向行动能力的趋势。

    但长程交互任务的训练难度很高。最重要的问题是反馈稀疏且延迟。Agent 往往要执行很多步之后,才在 episode 结束时得到成功或失败的奖励。这样一来,模型只能知道最终结果,却不知道中间哪一步是关键贡献,哪一步是无效动作。对于长程任务而言,这会严重影响学习效率,因为一个失败轨迹可能包含一些合理步骤,一个成功轨迹也可能包含一些冗余动作。如果训练方法不能拆解这些中间贡献,就很难真正提升 agent 的决策质量。

    现有方法大致有几类。一类是行为克隆或监督微调,主要模仿专家轨迹,优点是稳定,但缺点是无法从模型自己的错误中持续改进。另一类是 online RL,例如 PPO 或 GRPO,它们可以利用环境交互进行学习,但通常需要大量采样,而且没有专门解决稀疏奖励下的过程级归因。还有一类是 PRM 或搜索式方法,通过人工标注或在线搜索生成 step-level rewards,但这些方法往往成本高,并且容易出现奖励模型和策略分布不一致的问题。

    本文的问题意识正是在这里。作者认为,长程 LLM Agent 的关键难点不是单纯缺少奖励,而是过程奖励的可靠性依赖数据分布。如果一个 PRM 只在某些轨迹上训练,却被拿去评价策略优化后产生的新状态和新动作,它给出的分数就可能不可靠。因此,Q-Evolve 试图解决一个更根本的问题,即如何在同一分布内生成过程监督,并在同一分布内完成策略改进。

    3. 方法整体框架(Framework Overview)

    Q-Evolve 的整体框架可以理解为一个自进化闭环。第一步是行为克隆预热。作者先使用专家数据训练一个初始 agent,使模型具备基本任务执行能力。第二步是自生成数据收集。预热后的 agent 与环境交互,产生自己的成功和失败轨迹。第三步是构建 hybrid offline dataset。该数据集同时包含专家轨迹和 agent 自己生成的轨迹,因此既有高质量成功示范,也有模型真实分布下的错误样本。第四步是在该数据集上训练 in-distribution critic,并由 critic 推导 step-wise process rewards。第五步是利用这些过程奖励更新策略。更新后的策略再去环境中生成新轨迹,进入下一轮演化。

    这个框架的关键在于 hybrid data。专家数据可以提供成功任务路径,帮助 critic 获得可靠的高价值信号。自生成数据则反映当前 agent 真正会遇到的状态和动作,包括无效动作、格式错误、重复动作和局部合理但最终失败的行为。两类数据结合后,过程奖励不再只服务于专家分布,而是能覆盖模型自身的行为分布。

    另一个关键点是 in-distribution。Q-Evolve 并不是先训练一个静态 PRM,再让 policy 到新分布中自由探索,而是在每一轮演化中都把 critic learning、process reward labeling 和 policy learning 约束在同一个 hybrid dataset 内。这样做可以降低分布偏移风险,使奖励标注和策略更新互相匹配。

    因此,Q-Evolve 本质上不是一个单轮训练算法,而是一个 policy、critic 和 dataset 共同演化的系统。每一轮更新都比较保守,避免离开当前数据支持范围,但多轮迭代后又能逐步提升 agent 的长程任务能力。

    Self-evolving LLM Agents with In-distribution Optimization插图1

    4. 核心方法(Methodology)

    Q-Evolve 的核心方法可以分成四个部分。

    第一部分是行为克隆预热。作者使用专家轨迹训练初始策略,让 agent 学会基本任务格式和操作模式。对于长程交互任务,这一步很重要,因为完全随机探索很难获得成功轨迹,也很难为后续 critic learning 提供有效信号。行为克隆虽然不能解决最终的自进化问题,但可以为后续训练提供一个可用的起点。

    第二部分是 hybrid data construction 和 retrospective reward labeling。作者将专家轨迹和 self-collected rollouts 合并为一个离线数据集。随后,系统根据环境返回的文本反馈,对每一步进行规则化回看标注。例如,如果动作格式错误,会给出负奖励。如果动作不被环境接受,也会给出负奖励。如果动作执行后 observation 没有变化,则说明可能是无意义重复操作,也会被惩罚。这些辅助信号不需要人工标注,也不需要环境回溯,比较适合实际交互场景。

    第三部分是 in-distribution critic learning。作者采用 weighted Implicit Q-Learning 来训练 critic。普通 Bellman backup 理论上可以把终局奖励向前传播,但在稀疏奖励任务中容易被大量零奖励和失败轨迹淹没。因此,Q-Evolve 对不同样本进行加权,更重视成功轨迹和靠近终点的步骤。这样可以让 critic 更稳定地学习哪些中间行为更可能带来最终成功。

    第四部分是 process reward estimation 和 policy optimization。训练好 critic 后,作者不直接使用简单的 Q minus V 作为过程奖励,而是通过 GAE 估计 step-wise advantages。这样可以获得更平滑、更可靠的过程奖励。随后,模型使用 behavior-proximal policy optimization 更新策略。与普通 advantage weighted regression 不同,BPPO 不只是提高好动作的概率,还会显式压低负优势动作的概率,因此更适合纠正长程任务中的错误行为。

    整体来看,Q-Evolve 的方法设计比较克制。它没有让 policy 在未知分布中大幅跳跃,而是在已有数据支持范围内逐步改进。这种设计虽然看起来不激进,但正好符合长程交互任务中稳定性和安全性的要求。

    Self-evolving LLM Agents with In-distribution Optimization插图2

    5. 实验设置(Experimental Setup)

    论文在三个长程交互环境上进行实验,分别是 AlfWorld、WebShop 和 ScienceWorld。AlfWorld 是文本化家居任务环境,agent 需要通过较长动作序列完成 household tasks,最终只得到成功或失败的二值奖励。WebShop 是网页购物任务,agent 需要根据目标需求浏览商品并选择购买,最终奖励取决于购买商品是否满足属性要求。ScienceWorld 是虚拟科学实验环境,agent 需要完成包含多个子目标的科学任务,最终根据任务完成情况获得稀疏奖励。

    模型方面,作者主要使用 Llama2-7B-Chat 构建 agent,并在后续实验中进一步验证方法能迁移到 Llama-3-8B-Instruct。对于 self-collected data,作者让 agent 在每个任务上采样多条轨迹,用于构建混合离线数据集。

    基线方法覆盖较全面,包括 GPT-3.5-Turbo、GPT-4、Reflexion、SFT、RFT、PPO、Best-of-N、ETO、DMPO 和 QLASS。其中 QLASS 是一个比较强的 value-based agent 方法,通过搜索树估计 Q-value 来指导推理和动作选择。因此,Q-Evolve 与 QLASS 的比较尤其关键,因为两者都关注 value signal 和过程级指导,但 Q-Evolve 更强调 in-distribution learning 和样本效率。

    评价指标方面,论文报告各环境中的平均累计奖励,并在 ScienceWorld 和 AlfWorld 上区分 seen 和 unseen 任务,以检验模型是否只是记住训练任务,还是能泛化到未见场景。

    Self-evolving LLM Agents with In-distribution Optimization插图3

    6. 实验结果与性能分析(Experiments)

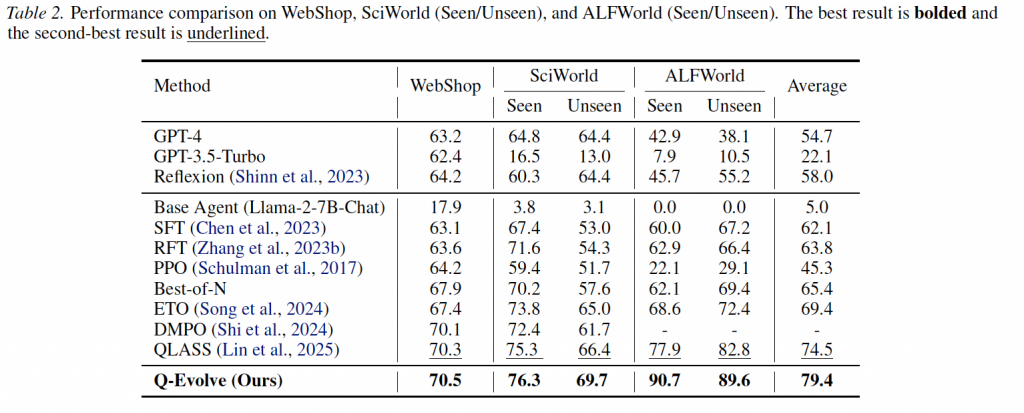
    主结果显示,Q-Evolve 在所有任务上的平均表现最好。根据 Table 2,Q-Evolve 的平均分达到 79.4,高于 QLASS 的 74.5,也明显高于 ETO、Best-of-N、RFT 和 SFT 等方法。尤其在 AlfWorld 上,Q-Evolve 在 seen 和 unseen split 上分别达到 90.7 和 89.6,显著超过其他方法。这说明它不仅能提升已见任务表现,也能在未见任务上保持较强泛化能力。

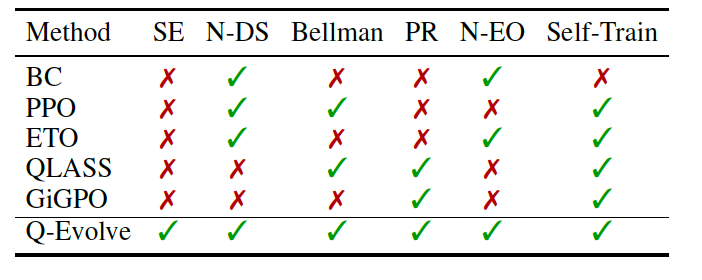
    与 QLASS 相比,Q-Evolve 的优势不只是分数更高,还体现在样本效率上。QLASS 需要大量在线搜索和 rollout 来估计 Q-values,而 Q-Evolve 主要依赖 hybrid offline dataset 和 in-distribution critic learning,在较少环境交互下就能获得更强效果。这个结果说明,对于长程 agent 训练而言,不一定要靠大量 online exploration,更关键的是如何稳定地把稀疏终局奖励转化为可靠的过程监督。

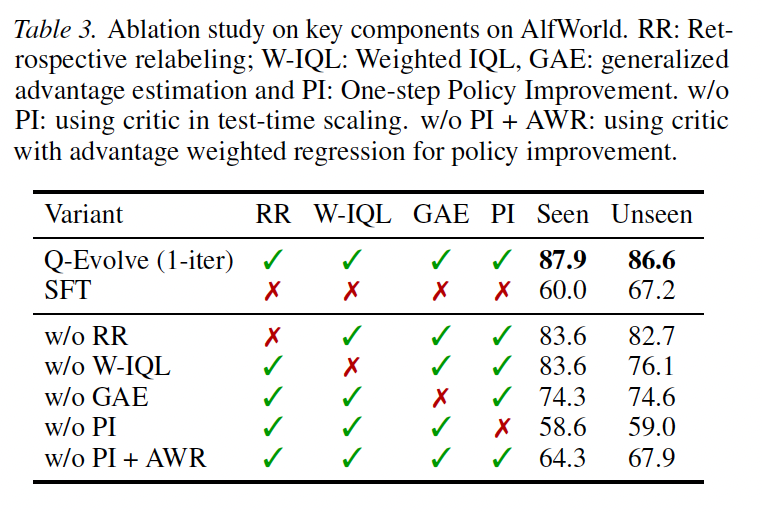
    消融实验进一步说明了各个模块的重要性。Table 3 显示,去掉 retrospective relabeling、weighted IQL、GAE 或 policy improvement 都会带来性能下降。其中去掉 GAE 后下降较明显,说明高质量 advantage estimation 是过程奖励可靠性的关键。去掉 policy improvement 后性能下降更严重,说明仅有 critic 或过程奖励还不够,必须通过合适的策略优化方法把这些信号转化为 agent 行为提升。

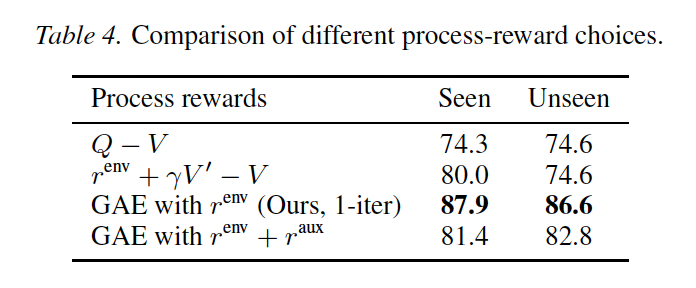
    论文还比较了不同过程奖励选择。Table 4 显示,直接使用 Q minus V 或 potential-based shaping 的效果都不如 GAE with environmental reward。作者进一步发现,将辅助奖励直接加入 GAE 反而会损害表现。这说明辅助奖励适合帮助 critic 训练和错误识别,但最终策略优化仍应与真实任务目标保持一致。

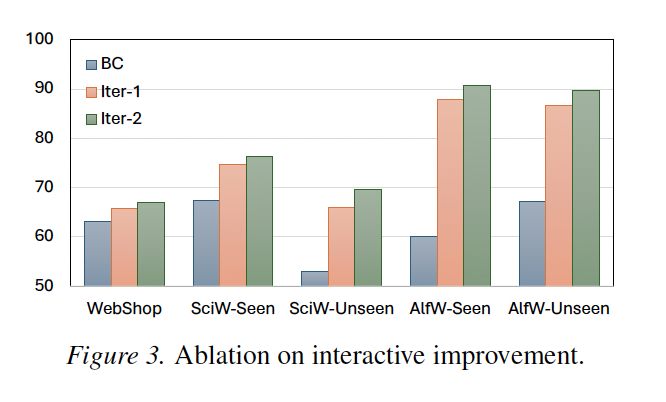
    在自进化效果方面,Figure 3 展示了从 BC 到 Iter 1 再到 Iter 2 的连续提升。多个任务上,第二轮演化相较第一轮继续提高,说明 Q-Evolve 不是一次性提升,而是真正能够通过数据刷新、critic 重学和策略再优化实现稳定迭代改进。

    样本效率实验也很有说服力。Table 5 显示,在 AlfWorld 上,Q-Evolve 只使用 13K 环境步数,就超过了使用 320K 环境步数的 PPO、RLOO、GRPO 及其 SFT 变体。这个结果说明,在稀疏奖励长程任务中,单纯增加 online RL 采样并不一定高效,合理的过程奖励生成和 in-distribution policy learning 可能更加关键。

    最后,Table 6 使用 Llama-3-8B-Instruct 进一步验证模型泛化性。Q-Evolve 在 WebShop、ScienceWorld 和 AlfWorld 上都优于 SFT、ETO、KnowAgent、WKM 和 ETO plus MPO 等方法,说明该框架不是只对某一个 base model 有效,而是具有一定架构和规模迁移能力。

    Self-evolving LLM Agents with In-distribution Optimization插图4
    Self-evolving LLM Agents with In-distribution Optimization插图5
    Self-evolving LLM Agents with In-distribution Optimization插图6
    Self-evolving LLM Agents with In-distribution Optimization插图7
    Self-evolving LLM Agents with In-distribution Optimization插图8

    7. 贡献与结论(Conclusion)

    本文的主要贡献包括以下几个方面。

    第一,提出 Q-Evolve,将自动过程奖励标注和策略学习统一到一个 in-distribution self-evolving framework 中。相比传统 PRM pipeline,它更重视过程奖励和策略优化之间的数据分布一致性。

    第二,设计 hybrid offline dataset,将专家示范和 agent 自生成轨迹结合起来。专家数据提供成功路径和高质量指导,自生成数据暴露模型真实错误和行为分布,两者共同提升 critic learning 的稳定性。

    第三,引入 weighted IQL 和 GAE,将稀疏终局奖励转化为 step-wise process rewards。这样既避免人工逐步标注,也不需要环境回溯或大量在线搜索。

    第四,采用 behavior-proximal policy optimization,在数据支持范围内进行保守策略更新。该方法不仅强化正优势动作,也压低负优势动作,有助于纠正长程决策中的错误行为。

    第五,在 AlfWorld、WebShop 和 ScienceWorld 上取得稳定提升,并在样本效率和跨模型泛化方面表现突出。

    从研究意义来看,这篇论文的重点不是单纯提出一个更强的 agent,而是回答了长程 LLM Agent 训练中的一个基础问题,即在只有终局奖励的情况下,如何可靠地生成过程监督,并让 agent 在不严重偏离数据分布的前提下持续自我改进。Q-Evolve 的答案是让 policy、critic 和 dataset 共同演化,同时保证每一轮更新仍然在当前数据分布内完成。

    整体来看,该工作对 LLM Agent 的训练有较强参考价值。它把 self-evolving agent 从概念层面推进到了一个更具体的强化学习框架中,也说明未来 agent 训练不能只关注最终任务成功率,还需要关注过程奖励的可靠性、数据分布的一致性和策略更新的稳定性。

  • Hierarchical Reinforcement Learning with Augmented Step-Level Transitions for LLM Agents

    Hierarchical Reinforcement Learning with Augmented Step-Level Transitions for LLM Agents

    1. 摘要(Abstract)

    本文研究的是 LLM Agents 在长程交互任务中的强化学习训练问题。现有大模型智能体在完成复杂环境任务时,通常会把完整的历史交互记录作为上下文输入,包括任务指令、过去观察、动作和中间状态等。这种做法虽然能帮助模型理解当前处境,但也带来了明显问题:随着任务步骤变长,输入上下文不断膨胀,推理成本和训练成本都会快速上升;同时,大量冗余或无关历史信息也可能干扰模型判断,影响长期决策质量。

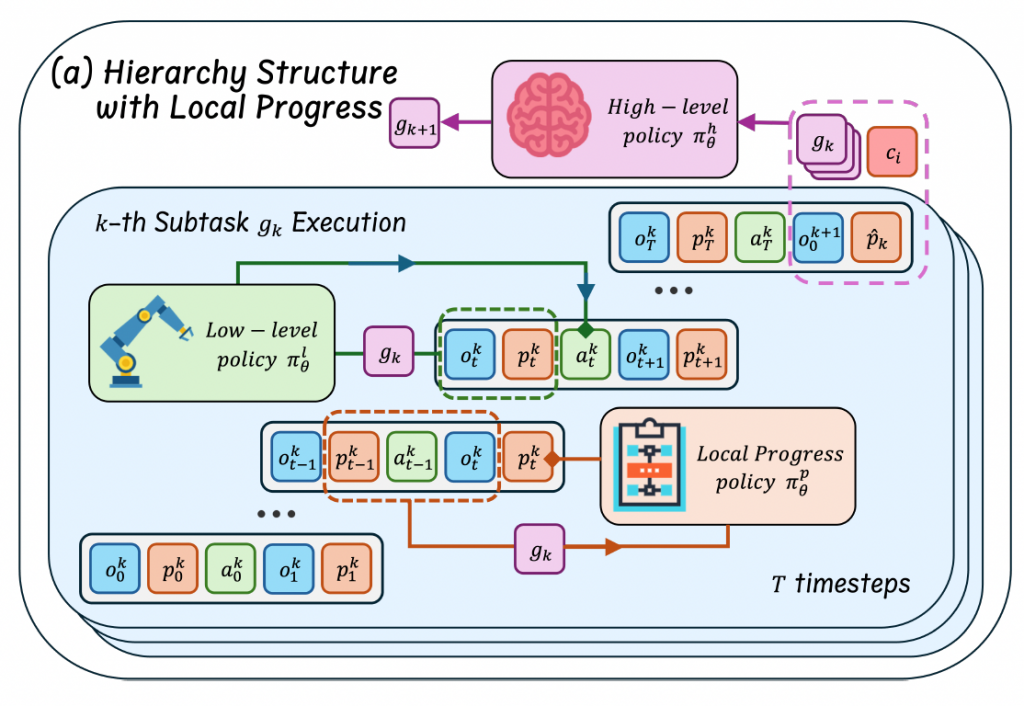
    针对这一问题,论文提出 STEP-HRL(Augmented Step-level Hierarchical Reinforcement Learning)。它的核心思想是:长程任务不一定必须依赖完整历史上下文,而可以通过“层次化任务结构 + 局部进展摘要”来构造更紧凑的 step-level transition。具体来说,STEP-HRL 将任务分为高层子任务规划和低层动作执行两个层次。高层策略负责生成子任务,低层策略负责在当前子任务下执行具体动作。同时,论文引入一个 local progress policy,用于持续总结当前子任务内部的关键进展,把局部历史压缩成简短的文本状态,从而避免低层策略反复读取完整历史。

    在训练方式上,STEP-HRL 采用两阶段流程。第一阶段使用专家轨迹进行 behavior cloning,让高层策略、低层策略和局部进展策略先学会基本输出格式和任务行为;第二阶段再进行 step-level offline RL,利用 actor-critic 框架对策略进一步优化。三个策略共享同一个 LLM backbone,并通过不同 critic network 分别学习不同层次的价值信号,以兼顾参数效率和层次化决策能力。
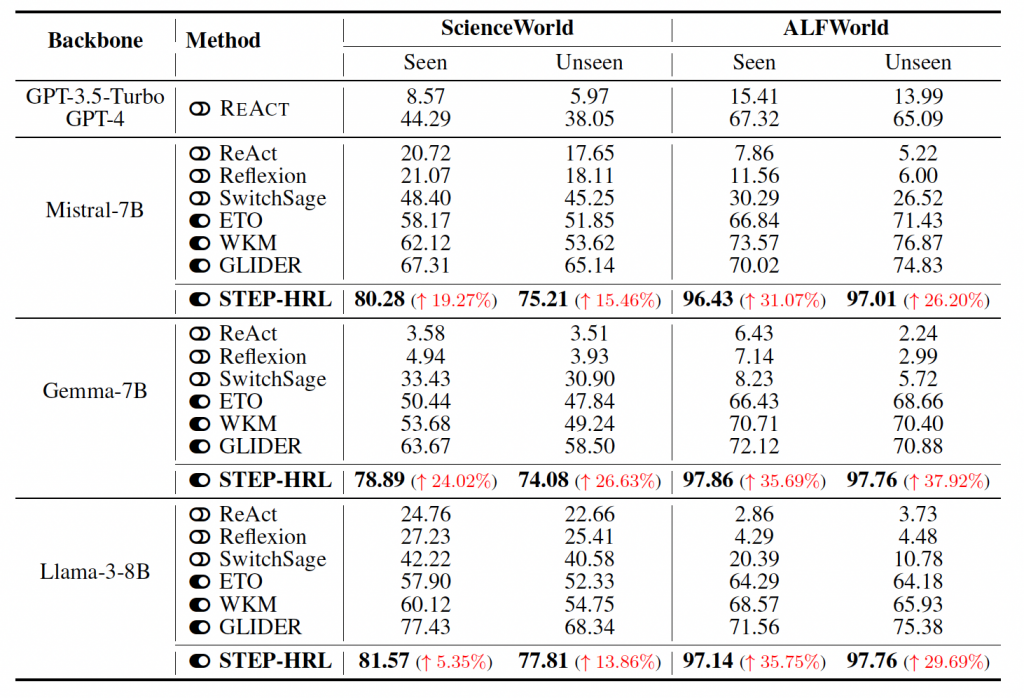
    实验在 ScienceWorld 和 ALFWorld 两个交互式决策基准上进行。结果显示,STEP-HRL 在 Mistral-7B、Gemma-7B 和 Llama-3-8B 等不同开源模型上都显著超过 ReAct、Reflexion、SwiftSage、ETO、WKM 和 GLIDER 等基线方法,并且在 unseen tasks 上也保持较好泛化能力。效率分析进一步表明,STEP-HRL 能显著降低 token usage,使每一步输入长度更加稳定。整体来看,这篇论文的重点不是简单提出一个新的 agent prompt 或任务分解方法,而是试图回答一个更基础的问题:LLM Agent 是否一定要依赖完整历史上下文,还是可以通过结构化进展表示实现更高效的 step-level learning?

    Hierarchical Reinforcement Learning with Augmented Step-Level Transitions for LLM Agents插图

    2. 研究背景与问题动机(Introduction)

    LLM Agents 已经在复杂交互任务中表现出较强能力,例如文本游戏、家庭任务规划、科学实验环境和工具调用任务等。相比单轮问答,这类任务更接近真实决策过程:模型需要根据环境反馈不断调整动作,并在多步交互中完成最终目标。因此,强化学习被认为是一条重要路线,因为它可以通过环境反馈优化策略,而不是只依赖固定示范数据。
    但现有 LLM Agent 的一个常见设定是 history-conditioned policy,也就是每一步决策都把完整历史交互记录输入模型。这种设计很自然,因为 Transformer 可以处理序列,过去的观察和动作也确实包含状态信息。然而,论文指出,这种做法把“长程决策”错误地等同于“长上下文建模”。随着交互步数增加,attention 计算成本会持续上升,而且未经筛选的历史记录会不断积累冗余信息,使模型更难抓住当前决策真正需要的线索。

    已有工作主要从两个方向缓解这个问题。一类方法尝试压缩历史,例如做 memory summary 或 context compression;另一类方法关注长期 credit assignment,希望更准确地判断哪些步骤对最终成功有贡献。但这些方法通常仍然保留了“策略依赖完整历史”的基本设定。即使是一些层次强化学习方法,也只是把任务拆成高层和低层,却仍让两个层次的策略读取累积历史,因此没有真正摆脱 long-context dependence。

    STEP-HRL 的动机正是重新审视这个前提。作者认为,长程任务真正需要的不是完整历史本身,而是能够表达任务进展的结构化信息。对全局任务来说,已经完成的子任务可以代表整体进展;对当前子任务来说,只需要保留与该子任务相关的局部进展摘要。因此,论文提出用 completed subtasks 表示 global progress,用 local progress module 表示 subtask-level progress,从而让策略基于单步转移进行学习,而不是依赖不断增长的历史上下文。

    这篇论文的问题意识比较清楚:它不是单纯问“如何让 LLM Agent 做得更好”,而是进一步问“LLM Agent 的状态表示是否必须是完整历史”。这个问题抓得比较基础,也更适合训练研究阅读中对核心矛盾的把握。

    Hierarchical Reinforcement Learning with Augmented Step-Level Transitions for LLM Agents插图1

    3. 方法整体框架(Method Overview)

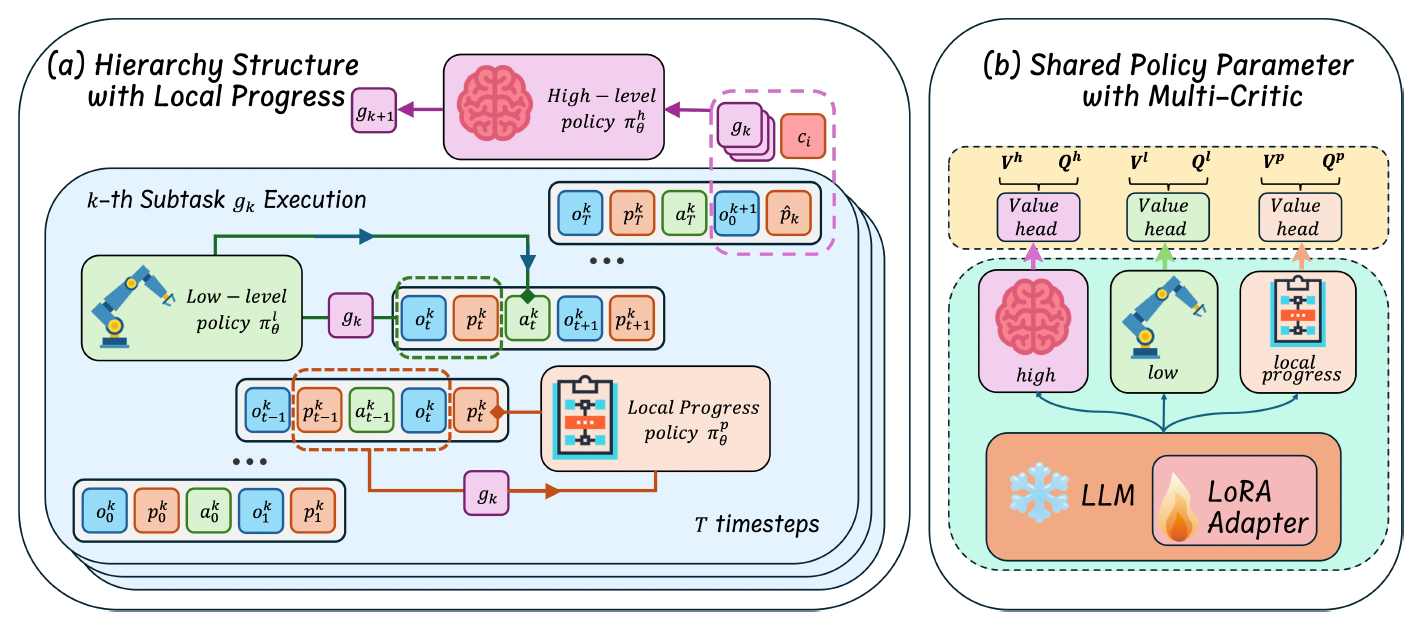
    STEP-HRL 的整体框架由三个策略组成:high-level policy、low-level policy 和 local progress policy。高层策略负责根据任务目标和已完成子任务生成下一个子任务;低层策略负责在当前子任务下执行具体环境动作;局部进展策略则负责在每一步更新当前子任务的 progress summary。三个策略虽然功能不同,但共享同一个 LLM 参数,只是在离线强化学习阶段配备不同的 critic network。

    在传统 HRL 中,高层策略通常根据完整全局历史生成子任务,低层策略则根据子任务和局部历史生成动作。STEP-HRL 对这一点做了改造。它认为,完整全局历史可以被已经完成的子任务序列近似表示;而子任务内部的局部历史,则由 local progress policy 逐步总结。这样,低层策略每一步只需要看到当前子任务、当前观察和当前局部进展,而不需要读取从任务开始到现在的全部记录。

    Local progress policy 是整个框架的关键。它在每个子任务内部持续工作:根据当前子任务、上一步动作、当前观察和上一个 progress summary,生成新的 progress summary。这个 summary 不是简单压缩全部历史,而是选择性保留与当前子任务相关的信息。比如在 ALFWorld 的家庭任务中,它可以记录已经找到的物体、已经打开的容器、物体当前位置等;在 ScienceWorld 中,它可以记录实验状态、已观察到的现象或已经完成的操作。

    这种设计让 STEP-HRL 得到两类 augmented step-level transitions。低层 transition 包含当前观察、局部进展、动作、奖励和下一步局部进展;高层 transition 则包含前一子任务的最终局部进展、下一个子任务初始观察、当前子任务、子任务奖励以及后续进展。通过这种方式,模型可以在 step-level 上学习,而不是在完整 trajectory 上学习。

    4. 核心方法:局部进展建模与两阶段训练(Core Method)

    STEP-HRL 的第一个核心是 local progress modeling。它解决的是“当前子任务内部到底发生了什么”这一问题。传统做法会把子任务内部的完整动作和观察都放进上下文,但 STEP-HRL 只保留一个不断更新的 progress summary。这个 summary 每一步都会被改写和补充,因此既能继承过去有用信息,又不会让输入长度随时间线性增长。

    第二个核心是 层次化 step-level transition。高层策略不再依赖完整历史,而是根据任务指令、已完成子任务、上一子任务的最终 progress 和下一子任务初始观察来生成新子任务。低层策略则根据当前子任务、当前 observation 和当前 local progress 来生成 primitive action。这样,长程任务被拆成多个更短、更清晰的局部决策过程,减轻了模型直接处理长历史的负担。

    第三个核心是 behavior cloning 初始化。由于 ScienceWorld 和 ALFWorld 这类环境具有专门的动作空间和状态表达,直接用 RL 训练 LLM Agent 往往效率很低。因此作者先从专家轨迹中构造三类示范数据:高层子任务生成数据、低层动作执行数据和局部进展生成数据。通过行为克隆,三个策略先学会基本任务格式和合理行为,为后续 offline RL 提供稳定起点。

    第四个核心是 step-level offline RL。作者在行为克隆模型基础上继续收集轨迹,并和专家数据混合形成离线数据集。随后采用类似 IQL/ILQL 的 actor-critic 方法:critic 估计每个 step-level state-action 的价值,policy 则通过 advantage-weighted regression 更倾向于学习高价值动作。与传统基于完整历史的 RL 不同,这里的状态就是前面构造出的单步状态表示,而不是整段历史。

    从方法设计上看,STEP-HRL 的创新点并不是某一个模块特别复杂,而是几个模块配合得比较紧:层次化结构负责降低任务复杂度,local progress 负责压缩局部历史,behavior cloning 负责稳定初始化,offline RL 负责提升泛化和策略质量。这些部分共同服务于一个目标:让 LLM Agent 可以在不依赖完整历史的情况下完成长程决策。

    5. 实验设置(Experimental Settings)

    论文在两个典型交互式决策基准上评估 STEP-HRL。第一个是 ScienceWorld,这是一个文本化科学任务环境,覆盖物理、化学、生物等多个任务族,要求智能体完成多步实验、观察和推理。这个基准的难点在于任务多样性较强,而且很多任务需要根据中间观察逐步调整操作。第二个是 ALFWorld,它来自家庭场景任务,包含 pick-and-place、清洁、加热等语言条件任务,更强调长程动作规划和环境交互。

    模型方面,论文主要使用三个开源 backbone:Mistral-7B、Gemma-7B 和 Llama-3-8B。同时,作者还在不同模型规模上做了分析,包括 Llama-1B、Llama-3B 和 Llama-8B,用来验证方法是否只对大模型有效。基线方法包括 prompt-based 的 ReAct、Reflexion、SwiftSage,也包括 LoRA fine-tuning 的 ETO、WKM 和 GLIDER。此外,论文还引用了 GPT-3.5-Turbo 和 GPT-4 在相关任务上的结果作为参考。

    训练流程上,所有微调类方法都使用 LoRA。STEP-HRL 先进行 behavior cloning,再进行 offline RL。专家轨迹中的子任务和 local progress annotation 由 DeepSeek 生成,offline RL 数据则由行为克隆后的策略继续收集。这个设置说明 STEP-HRL 并不是完全不依赖示范数据,它仍然需要较高质量的结构化轨迹作为训练基础。

    Hierarchical Reinforcement Learning with Augmented Step-Level Transitions for LLM Agents插图2

    6. 实验结果与分析(Experiments)

    主结果见 Table 1。整体来看,STEP-HRL 在三个 backbone 上都明显优于已有方法,而且在 seen 和 unseen tasks 上都有稳定提升。在 ScienceWorld 上,STEP-HRL 相比强基线 GLIDER 仍能继续提高,说明它不只是靠层次化任务分解本身,而是 local progress 和 step-level learning 确实带来了额外收益。在 ALFWorld 上,STEP-HRL 的成功率基本达到 96% 到 98% 左右,已经接近饱和表现,说明它在较规则的家庭任务环境中非常有效。

    更值得注意的是 unseen tasks 的表现。很多 agent 方法在 seen tasks 上可以通过模仿或记忆取得不错结果,但在 unseen tasks 上容易下降。STEP-HRL 在 ScienceWorld unseen 和 ALFWorld unseen 上仍然保持较高成绩,说明它学到的不只是具体轨迹,而是更可迁移的任务进展表示和层次化决策方式。

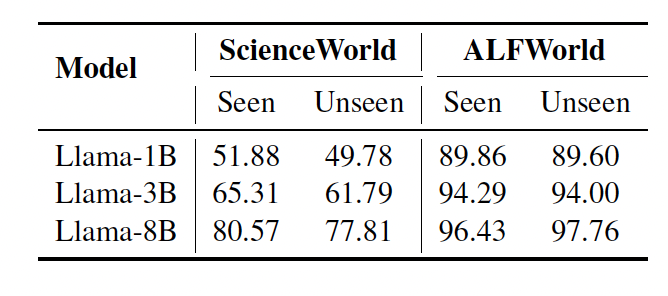
    Table 2 展示了不同模型规模下的结果。随着模型从 Llama-1B 到 Llama-8B 增大,ScienceWorld 和 ALFWorld 上的表现整体上升。不过,即使是 Llama-1B,在 ALFWorld 上也能达到接近 90% 的成功率,说明 STEP-HRL 对小模型也有帮助。这一点很重要,因为如果一种 agent 训练方法只能在大模型上工作,实际部署价值会受限;而 STEP-HRL 显示出一定的 scale robustness。

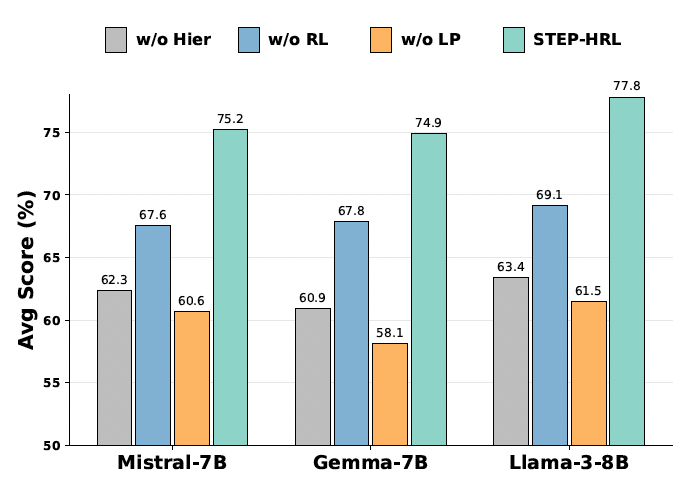
    消融实验见 Figure 2。作者分别去掉 local progress、去掉 hierarchical structure、去掉 offline RL。结果显示,三种变体都会下降,其中 local progress 的作用尤其明显。没有 local progress 时,模型只能根据当前 observation 和子任务决策,很多历史状态会变得不可区分,导致 credit assignment 和动作选择都更困难;没有层次结构时,local progress 需要独自承担全局长历史压缩,压力过大;没有 offline RL 时,模型退化为 behavior cloning,泛化能力不足。这个消融结果支撑了论文的核心判断:STEP-HRL 的效果来自层次结构、局部进展建模和离线强化学习三者共同作用。

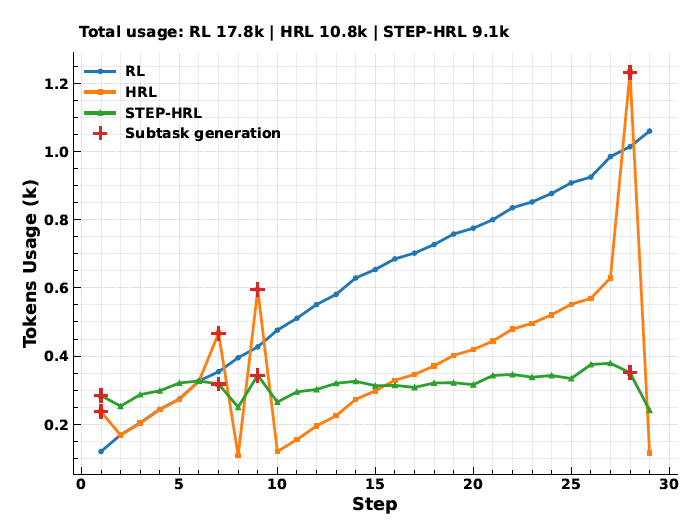
    效率分析见 Figure 3 和 Table 3。在相同观察和动作序列下,普通 RL 方法的 token usage 会随着步数持续上升,因为每一步都要读完整历史;传统 HRL 虽然整体减少 token,但在生成子任务时会出现明显峰值;STEP-HRL 则基本保持稳定,每一步输入长度波动小。该实验中,总 token usage 分别为 RL 17.8k、HRL 10.8k、STEP-HRL 9.1k,说明 STEP-HRL 不仅效果更好,也更节省上下文。Table 3 则显示,STEP-HRL 在早期步骤可能略慢,因为它包含多个策略和额外 progress generation;但随着历史增长,普通 agent 的延迟逐渐上升,而 STEP-HRL 保持稳定,更适合长程任务。

    最后,Figure 4 分析了 offline RL 的敏感性。结果显示,advantage temperature、expectile parameter、数据来源和数据量都会影响最终表现。混合专家数据和 BC-collected 数据通常优于只用其中一种,说明专家数据提供高质量轨迹,而模型自己收集的数据则补充了更真实的失败和偏差样本。数据量也不是越大越好,过多低质量或冗余样本反而会影响稳定训练。

    Hierarchical Reinforcement Learning with Augmented Step-Level Transitions for LLM Agents插图3
    Hierarchical Reinforcement Learning with Augmented Step-Level Transitions for LLM Agents插图4
    Hierarchical Reinforcement Learning with Augmented Step-Level Transitions for LLM Agents插图5
    Hierarchical Reinforcement Learning with Augmented Step-Level Transitions for LLM Agents插图6

    7. 贡献与结论(Contributions and Conclusion)

    本文的主要贡献可以概括为四点。

    第一,论文提出 STEP-HRL,将 LLM Agent 的长程决策从完整历史条件建模,转向基于 progress representation 的 step-level learning。这个视角比较重要,因为它把问题从“如何塞进更长上下文”转为“如何构造更有效的状态表示”。

    第二,论文设计了 local progress module,用于在每个子任务内部选择性总结交互历史。它既保留了当前子任务中有用的信息,又避免上下文无限增长,是 STEP-HRL 区别于普通 HRL 的关键。

    第三,论文提出参数高效的训练框架,使高层策略、低层策略和局部进展策略共享同一个 LLM backbone,并通过不同 critic network 分别学习不同层次的价值信号。这样既降低训练和推理开销,也促进不同层次之间的知识迁移。

    第四,论文在 ScienceWorld 和 ALFWorld 上进行了较全面实验,证明 STEP-HRL 在性能、泛化和 token efficiency 上都优于已有 agent 方法。尤其是在 unseen tasks 上的提升,说明这种 step-level progress representation 具有一定泛化价值。

    当然,这篇论文也有局限。作者在结论后明确提到,STEP-HRL 依赖高质量专家示范,尤其需要构造子任务和 local progress,这在复杂环境中并不总是容易。另一个问题是,子任务终止由低层输出同时预测,可能出现提前终止或延迟终止,从而影响 transition 质量和高低层协同。这些局限说明 STEP-HRL 并没有彻底解决 LLM Agent 的长程决策训练问题,但它提供了一个很清晰的方向:未来的 agent 不一定要不断扩大上下文窗口,而可以通过更结构化的任务进展表示来提高效率和鲁棒性。

    总体来看,这篇论文的价值在于,它抓住了 LLM Agent 中一个容易被忽略的问题:长程交互不等于长上下文输入。STEP-HRL 通过层次化结构和局部进展摘要,把复杂历史转化为可控的 step-level state,使 LLM Agent 的强化学习训练更高效、更稳定,也更容易泛化到新任务。

  • Towards Next-Generation Global IoT: Empowering Massive Connectivity with Harmonious Multi-Network Coexistence

    Towards Next-Generation Global IoT: Empowering Massive Connectivity with Harmonious Multi-Network Coexistence

    1. 论文概述与研究背景

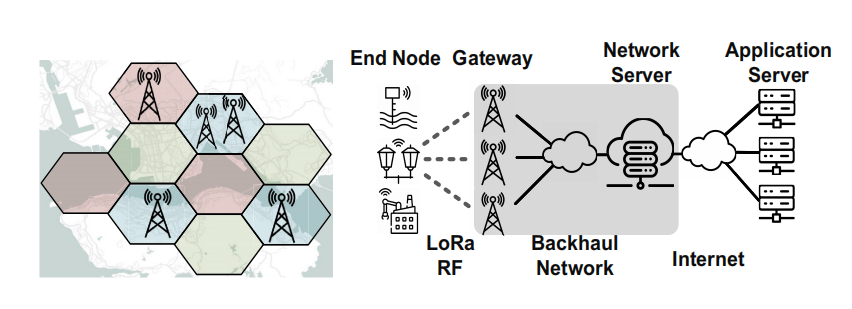
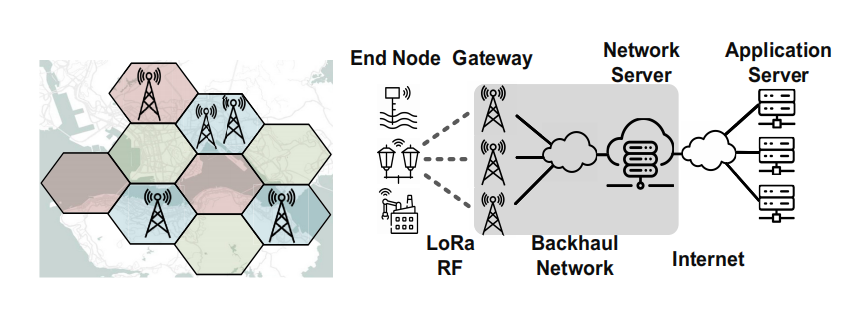
    本论文针对LoRaWAN作为全球IoT基础设施所面临的扩展性挑战展开深入探讨。LoRaWAN以其低成本、长距离和低功耗特性,成为连接数百万IoT设备的首选技术。然而,实际运营网络显示出显著的容量限制问题。作者通过对真实运营LoRaWAN网络的实证研究发现,传统认知中的无线争用和干扰并非主要瓶颈,而是首次揭示了一种新的“解码器争用问题”(decoder contention problem)。这一问题源于网关有限的解码器资源(如典型COTS网关仅支持16个并发解码),导致在高并发场景下大量数据包被丢弃。论文强调,尽管LoRaWAN采用免许可ISM频段并支持多网络共存,但当前运营策略缺乏合作机制,反而加剧了容量退化。研究目标是揭示根因并提出可部署解决方案,以实现多网络和谐共存和接近理论容量的性能提升。

    论文作者来自香港理工大学,发表于SIGCOMM 2025,研究结合实地测量、系统设计和大规模评估,展现了严谨的学术风格。背景部分详细对比了LoRaWAN与其他LPWAN技术的差异,指出其在智能城市、农业和公用事业等领域的潜力,但也明确当前系统仅支持极低并发(如TTN网络最多16个并发用户),远低于理论上限。这为后续章节的根因分析和方案设计奠定了基础。

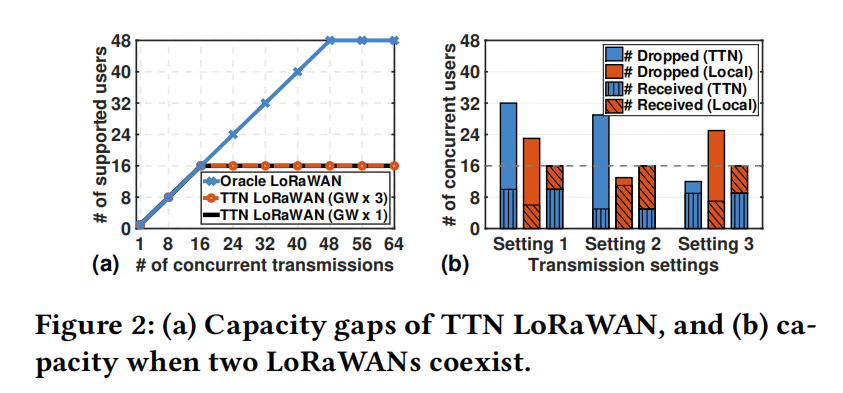
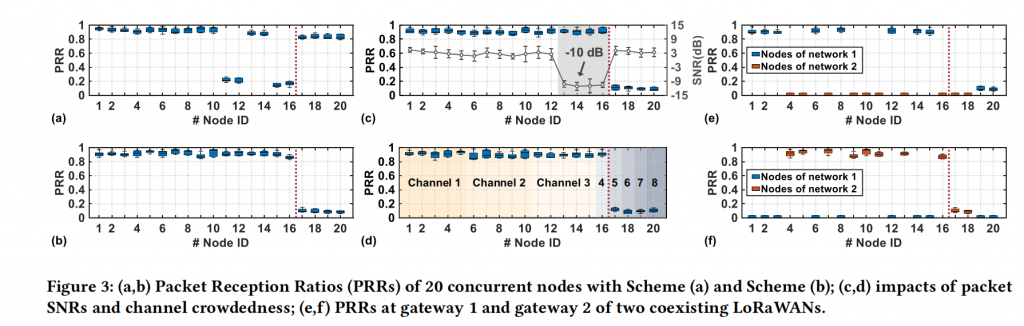
    论文第二部分通过真实实验量化了容量差距。在TTN全球网络和本地实验网络中,即使增加网关数量也无法显著提升容量,多网络共存时总并发仍被限制在16左右。这表明问题并非简单干扰,而是系统性资源争用。作者系统性地分析了网关接收机制,确认COTS网关采用FCFS(先到先得)方式处理数据包,先到数据包占用解码器,后续包被丢弃。实验还显示,同质信道配置导致多网关观察相同数据包序列,无法发挥冗余优势;跨网络数据包在解码前竞争资源,进一步恶化问题。这些发现颠覆了传统观点,为设计新原则提供了关键洞见。

    2. 解码器争用问题的根因分析

    第三章深入剖析LoRaWAN网关的接收流水线,揭示解码器资源的物理限制是核心瓶颈。典型SX1302芯片支持8个信道但仅16个解码器,数据包根据前导码锁定时间顺序处理。实验通过精心控制20个节点在微时隙发送,证明了锁定时序决定接收顺序,且SNR和信道拥挤度对优先级无显著影响。更重要的是,跨网络数据包即使被过滤,也会先消耗解码器资源,因为网络标识需解码后才能识别。这导致所有共存网络的数据包在每个网关处竞争,形成全局容量瓶颈。

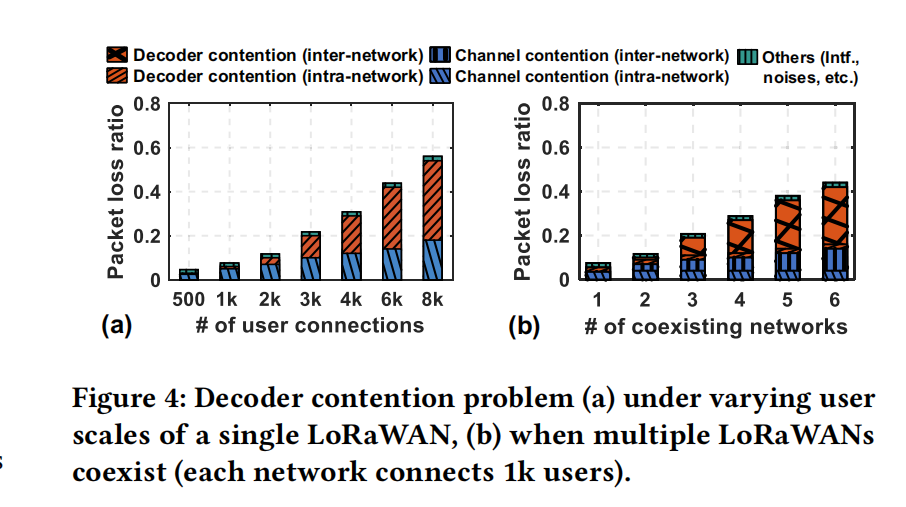
    此外,标准运营策略的缺陷进一步放大问题:同质信道计划使多网关接收相同早期包,浪费资源;缺乏用户-网关关联导致部分用户占用多网关解码器,而其他用户无资源可用。论文通过大规模包丢失分类实验证明,当网络规模超过3000用户或多网络共存时,解码器争用成为主导丢包原因,远超传统信道争用。这为后续策略设计提供了坚实依据。

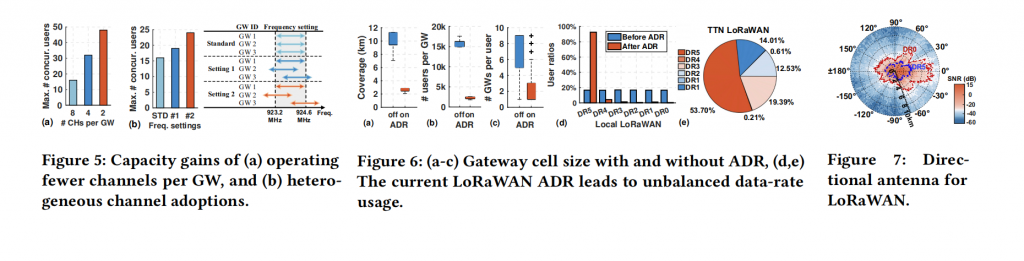
    作者还讨论了该问题在长期运营中的影响,包括难以通过简单增加网关或频谱来扩展容量。现有技术如ADR(自适应数据率)虽能缩小小区,但导致数据率分布不均,频谱利用率低下;定向天线因LoRa高灵敏度也效果有限。这些分析凸显了需要从频谱优化、资源管理和网络隔离等多维度解决问题的必要性。

    3. AlphaWAN设计原则与策略

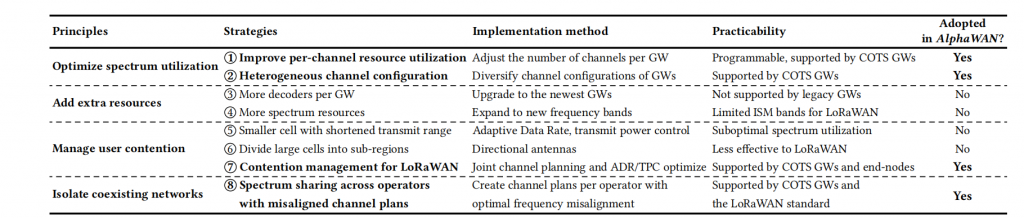
    第四章提出四大设计原则:优化频谱利用、增加资源、管理用户争用和隔离共存网络,并衍生出八项具体策略。论文重点采用策略①(减少每个网关信道数以提升单信道解码资源)、②(异构信道配置)、⑦(联合信道规划与ADR优化)和⑧(跨运营商频谱共享)。这些策略无需修改COTS硬件或协议,具备良好兼容性。

    Towards Next-Generation Global IoT: Empowering Massive Connectivity with Harmonious Multi-Network Coexistence插图

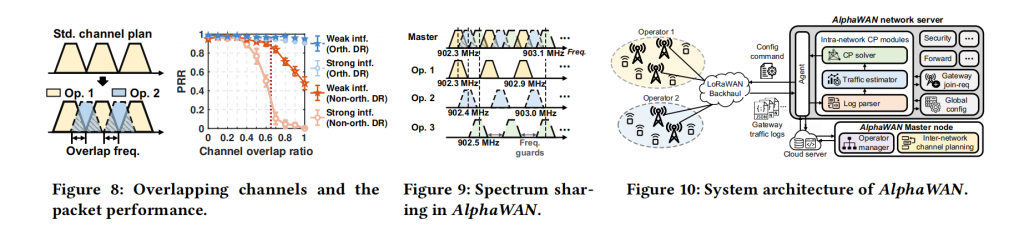
    AlphaWAN引入两个核心原语:网内信道规划和网间信道规划。前者通过进化算法优化网关和节点的信道、数据率和功耗配置,最小化各网关的解码器过载风险;后者由中心Master节点协调,分配具有合适频率错位的信道计划,实现物理隔离,减少跨网争用。实验验证了>30%频率错位即可维持高可靠性,同时利用LoRa正交数据率特性控制干扰。

    Towards Next-Generation Global IoT: Empowering Massive Connectivity with Harmonious Multi-Network Coexistence插图1

    系统实现基于ChirpStack平台,包含日志解析、流量估计和CP求解器等模块。网关代理和端节点通过ADR命令动态配置,实现无缝升级。该设计充分考虑了实际部署约束,如遗留设备兼容性和法规遵从,体现了极强的工程实用性。

    4. 实验评估与性能验证

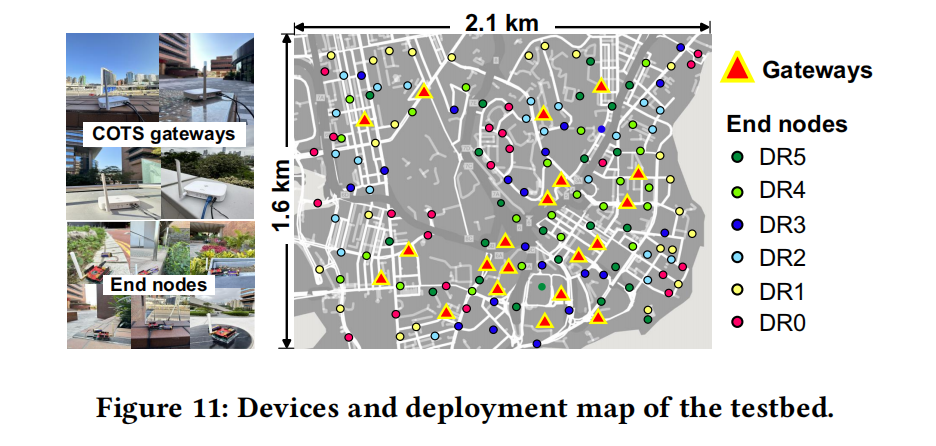
    第五章通过真实测试床(15个网关、144个节点、覆盖2.1km×1.6km城区)全面评估AlphaWAN。在单网络场景下,AlphaWAN随网关数量增加线性提升容量,最终达到理论上限,比标准LoRaWAN提升显著;在频谱效率上,全版本AlphaWAN比基准高292.2%。跨网络共存实验中,支持6个网络时频谱利用率提升778.1%。

    Towards Next-Generation Global IoT: Empowering Massive Connectivity with Harmonious Multi-Network Coexistence插图2
    Towards Next-Generation Global IoT: Empowering Massive Connectivity with Harmonious Multi-Network Coexistence插图3
    Towards Next-Generation Global IoT: Empowering Massive Connectivity with Harmonious Multi-Network Coexistence插图4

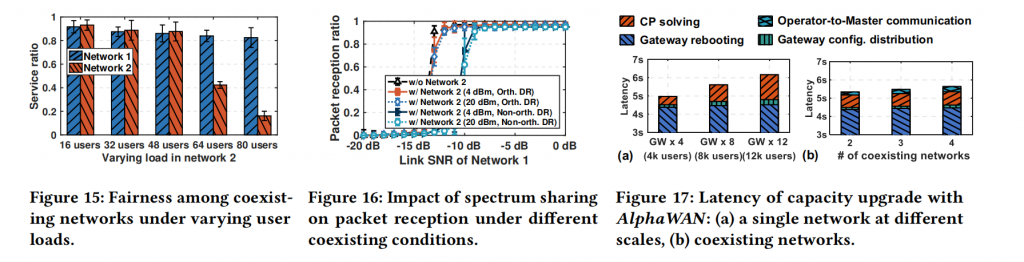
    大规模模拟(14000+用户)显示,AlphaWAN在高负载下维持>85% PRR,而传统方法和SOTA方案(如LMAC、CIC)在解码器争用主导后饱和。部分采用实验证明AlphaWAN能与遗留网络友好共存,并通过公平性测试和延迟分析(升级操作<10秒)验证实用性。微基准测试进一步确认了隔离效果和干扰可控性。

    Towards Next-Generation Global IoT: Empowering Massive Connectivity with Harmonious Multi-Network Coexistence插图5
    Towards Next-Generation Global IoT: Empowering Massive Connectivity with Harmonious Multi-Network Coexistence插图6

    长期模拟实验展示了AlphaWAN在用户扩张和多运营商场景下的鲁棒性,通过动态增加网关、扩展频谱和频谱共享机制,始终维持高PRR,远优于标准实现。

    Towards Next-Generation Global IoT: Empowering Massive Connectivity with Harmonious Multi-Network Coexistence插图7
    Towards Next-Generation Global IoT: Empowering Massive Connectivity with Harmonious Multi-Network Coexistence插图8
    Towards Next-Generation Global IoT: Empowering Massive Connectivity with Harmonious Multi-Network Coexistence插图9

    5. 结论、意义与未来展望

    论文结论强调,解码器争用问题是制约LoRaWAN全球规模部署的核心障碍,AlphaWAN提供了一套完整、可立即部署的解决方案,推动LoRaWAN向下一代全球IoT基础设施演进。其贡献包括问题新发现、策略系统探索和实用系统实现,具有重要的理论和工程价值。

    研究对IoT产业意义重大:运营商可通过AlphaWAN以现有资源支持3倍以上连接,多网络和谐共存将加速智慧城市等应用落地。未来可进一步探索AI辅助优化、动态Master协调等方向。

    总体而言,这是一篇高质量的系统研究论文,结合严谨测量、创新设计和全面评估,为LoRaWAN领域提供了重要参考。

  • SkILLOPT: Executive Strategy forSelf-Evolving Agent Skills

    SkILLOPT: Executive Strategy forSelf-Evolving Agent Skills

    1. 论文概述与引言

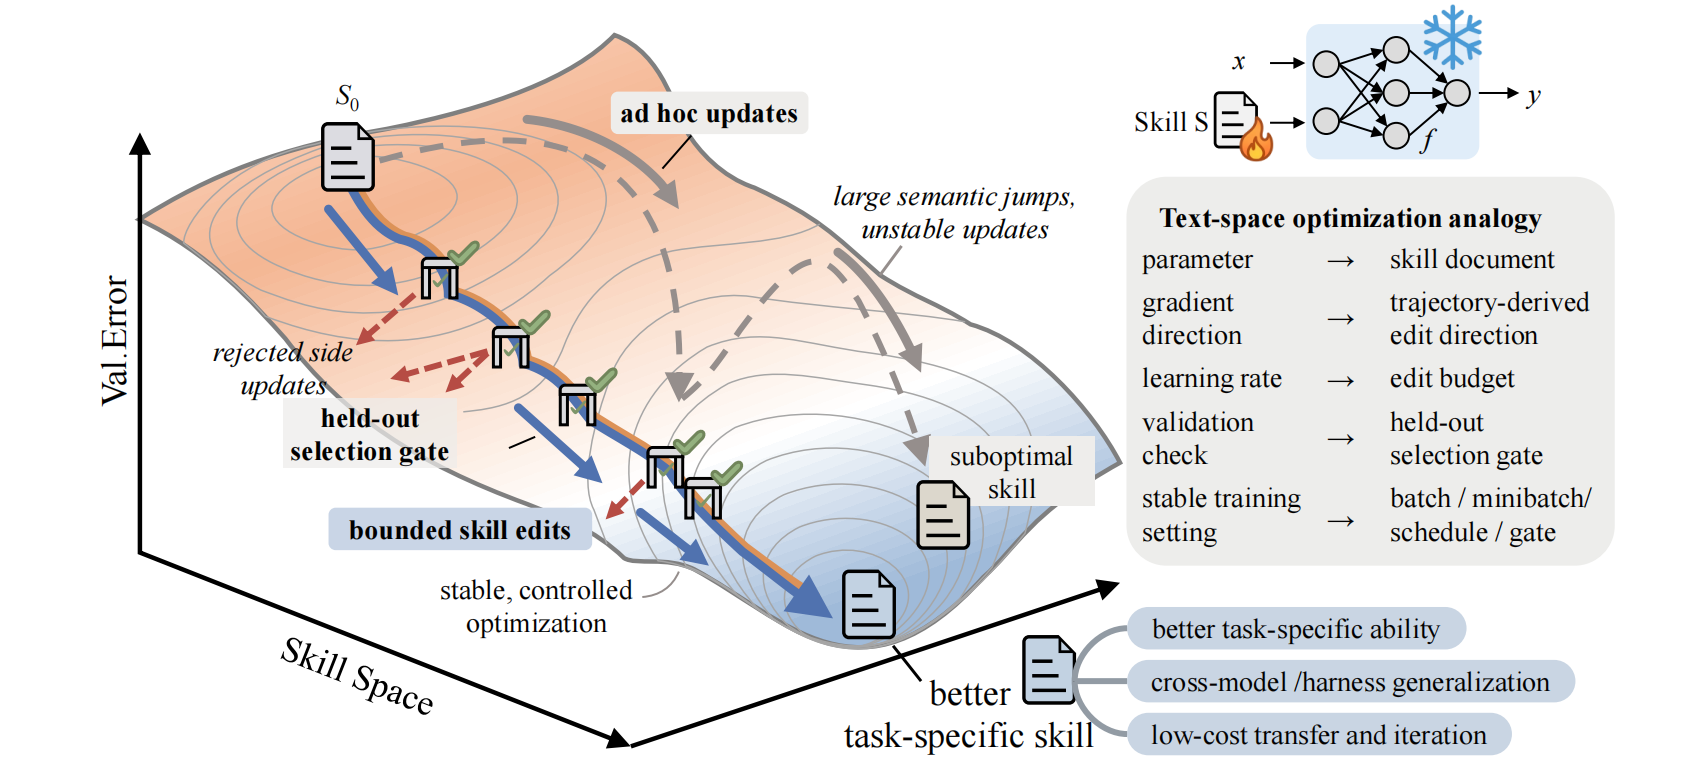
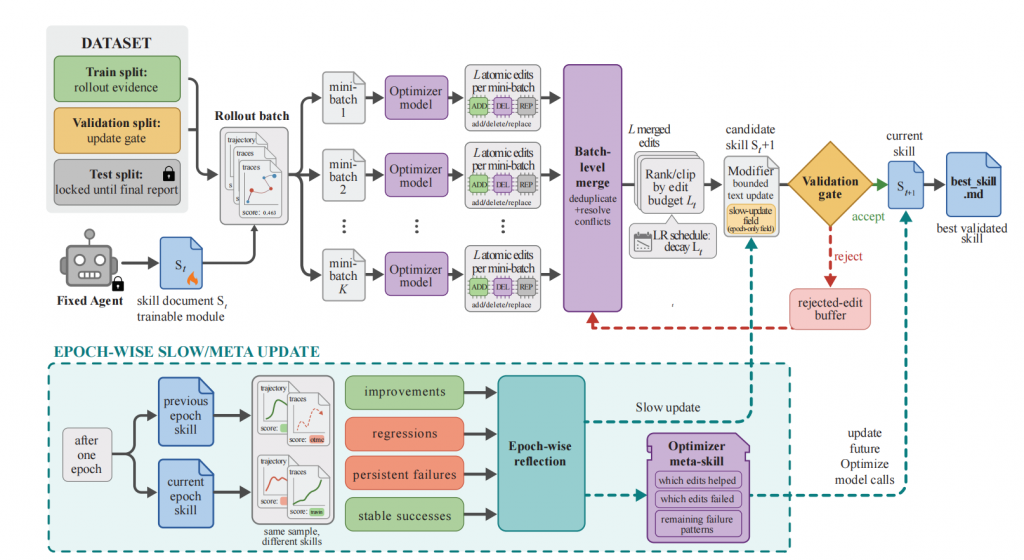
    SKILLOPT提出了一种开创性的文本空间优化框架,用于实现代理技能的自进化。该论文深刻指出,当今代理技能主要依赖手工 crafting、单次 LLM 生成或松散的自修订循环,这些方法均无法像深度学习优化器那样提供系统、可控且可重复的改进路径。作者主张,应将技能文档视为冻结代理模型的外部可训练状态,引入独立的 frontier 优化器模型。该优化器通过分析带分数的 rollout 轨迹,生成受限的 add/delete/replace 编辑操作,并仅在编辑能严格提升 held-out 验证集得分时才接受。这种严格的验证门控机制,完美模拟了权重空间优化的纪律性和稳定性,避免了传统提示工程中常见的漂移和退化问题。

    论文强调,代理技能作为领域适应的核心接口,能够系统性地封装程序性知识、领域特定启发式、工具使用策略、输出格式约束以及常见失败模式,从而让冻结的底层模型通过外部文本实现高效适应。SKILLOPT 创新性地引入了文本形式的 learning-rate 预算、拒绝编辑缓冲区以及逐 epoch 的慢/元更新机制,确保整个技能训练过程既稳定又高效。在六个多样化基准(涵盖 QA、电子表格、文档、多模态、数学和具身决策)、七个不同规模的目标模型以及三种执行 harness(直接聊天、Codex、Claude Code)上,SKILLOPT 在全部 52 个评估单元中均取得最佳或并列最佳成绩。在 GPT-5.5 直接聊天模式下,平均准确率提升高达 23.5 个百分点,充分展示了其在实际代理任务中的强大潜力。该方法的核心价值在于将技能进化转化为一个可严格验证的优化循环,而非传统的 ad-hoc 提示修改,这为未来代理系统的持续改进提供了坚实的理论和实践基础。

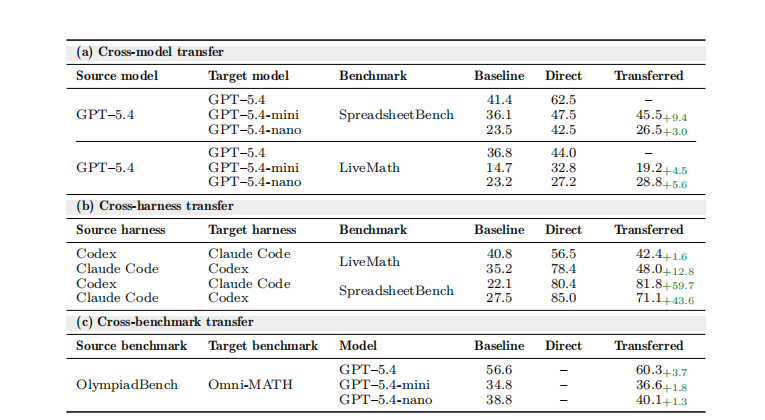
    SKILLOPT 的另一重大创新在于其零推理时开销设计。优化过程完全离线进行,最终仅导出一个紧凑的 best_skill.md 文件,部署时无需额外调用优化器模型。转移实验进一步强化了其实用性:优化后的技能能在不同模型规模之间、不同执行环境之间以及相近基准任务上保持显著正向迁移效果,这大大降低了实际生产环境中领域适应的成本,为企业级代理部署提供了可扩展的解决方案。

    SkILLOPT: Executive Strategy forSelf-Evolving Agent Skills插图

    2. 方法论核心设计

    SKILLOPT 的优化循环由多个精心设计的阶段构成,包括前向 rollout 证据收集、后向小批量反思、有界文本更新、验证门控以及逐纪元慢/元更新。在前向阶段,目标模型使用当前版本的技能在训练集上执行批量任务,harness 详细记录轨迹中的元数据、工具调用、观察结果、最终答案和验证器反馈,为后续优化提供丰富且结构化的证据。后向反思阶段,优化器模型首先将成功和失败轨迹分离,并进一步划分为小批量进行分析。这种小批量处理方式能有效发现系统性的程序性错误,而非仅针对单个孤立案例提出临时修复。

    SkILLOPT: Executive Strategy forSelf-Evolving Agent Skills插图1

    有界文本更新是 SKILLOPT 最核心的创新之一。通过引入文本学习率 Lt(每次步骤允许的最大编辑数量),系统有效防止了无界重写可能带来的有用规则擦除或不兼容指令引入的问题。优化器会对合并后的编辑池进行排名,并严格限制在当前预算内。候选技能生成后,必须通过 held-out 验证集的严格评估(得分需严格高于当前最佳),才能被正式接受;否则进入拒绝缓冲区,作为后续优化的负反馈信号。逐纪元慢/元更新则负责捕捉跨 epoch 的长期模式,通过对比前后 epoch 的表现,生成保护字段中的纵向指导,进一步提升优化的长期稳定性和泛化能力。这种多层次控制机制,使得技能优化过程真正具备了类似深度学习训练的系统性、可解释性和鲁棒性。

    SkILLOPT: Executive Strategy forSelf-Evolving Agent Skills插图2

    此外,方法特别注重 harness 无关性和可移植性。通过轻量级适配器接口,同一优化框架可无缝支持直接聊天、Codex 风格代码执行和 Claude Code 环境。这种设计彻底将技能定位为可复用的领域适应层:强大的优化器仅在训练阶段发挥作用,部署时仅需加载精炼后的技能文档即可显著提升任意目标模型的表现,极大降低了实际应用门槛。

    3. 实验结果与性能表现

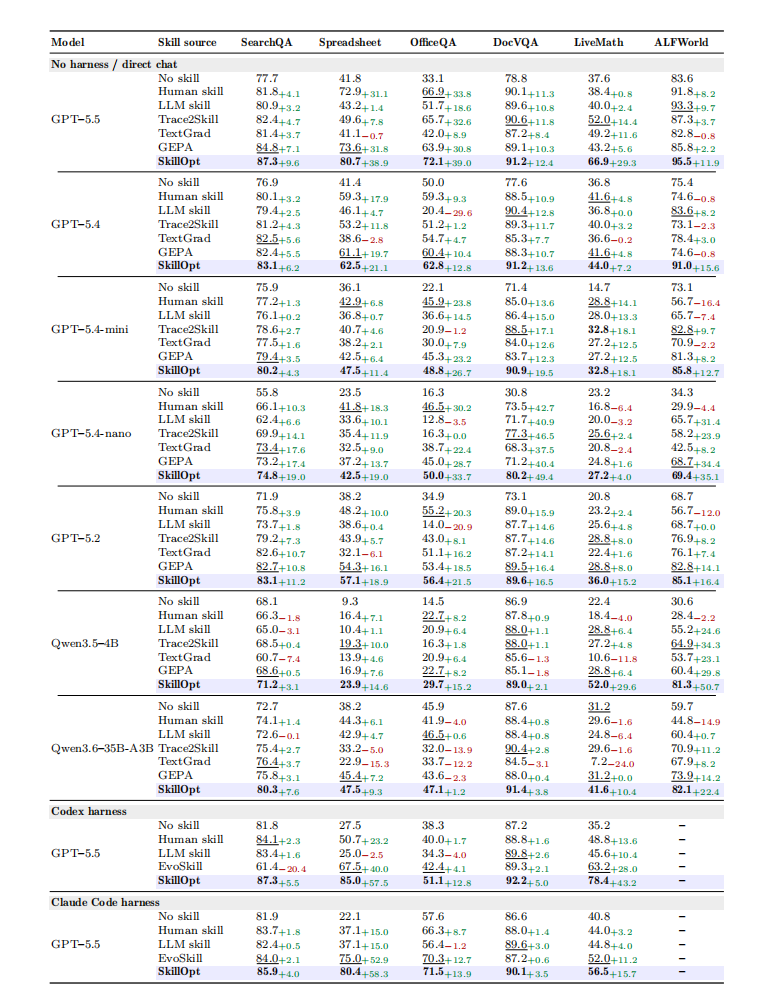
    实验设计全面且严谨,涵盖 SearchQA、SpreadsheetBench、OfficeQA、DocVQA、LiveMathematicianBench 和 ALFWorld 六个代表性基准,横跨 GPT 系列前沿模型到 Qwen 小模型,并在直接聊天、Codex 以及 Claude Code 三种执行模式下进行评估。SKILLOPT 在全部 52 个(模型、基准、harness)评估单元中均取得最佳或并列最佳成绩,全面超越人类手工技能、单次 LLM 生成技能、Trace2Skill、TextGrad、GEPA 以及 EvoSkill 等主流基线,展现出压倒性优势。

    SkILLOPT: Executive Strategy forSelf-Evolving Agent Skills插图3

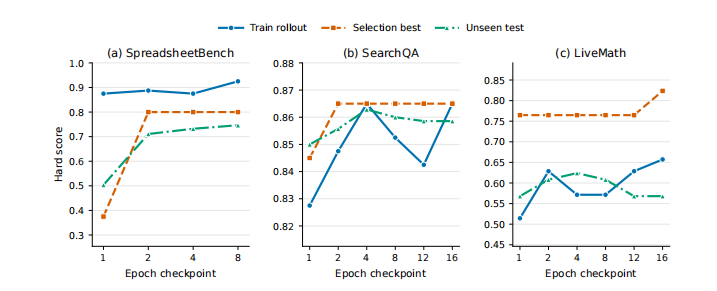
    特别是在 GPT-5.5 直接聊天模式下,SKILLOPT 将平均性能从无技能的 58.8 提升至 82.3,净增 23.5 个百分点。其中程序化任务受益最为显著:SpreadsheetBench 从 41.8 跃升至 80.7,OfficeQA 从 33.1 提升至 72.1,LiveMathematicianBench 从 37.6 升至 66.9。这些大幅提升充分说明,SKILLOPT 能有效注入前沿模型欠缺的程序性纪律和领域知识。在 Codex 和 Claude Code 等工具增强执行环境中,同样分别取得 +24.8 和 +19.1 的平均提升,证明该方法对复杂多轮交互场景同样适用。

    SkILLOPT: Executive Strategy forSelf-Evolving Agent Skills插图4

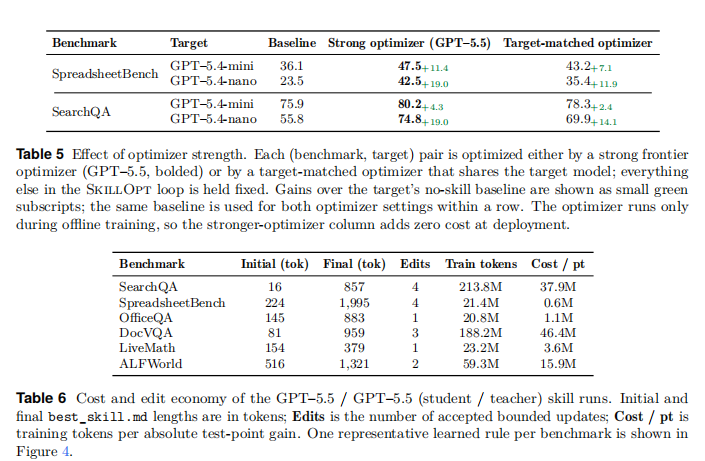
    值得注意的是,小规模和较弱模型从优化技能中获益尤为明显。例如 GPT-5.4-nano 在多个基准上实现了接近翻倍的性能跃升。这表明紧凑的技能文档能有效补充小模型权重中缺失的程序性知识。跨模型、跨 harness 和跨基准的转移实验进一步验证了技能的鲁棒性和复用价值,为实际部署提供了强有力的支撑。

    4. 消融分析与技能特性

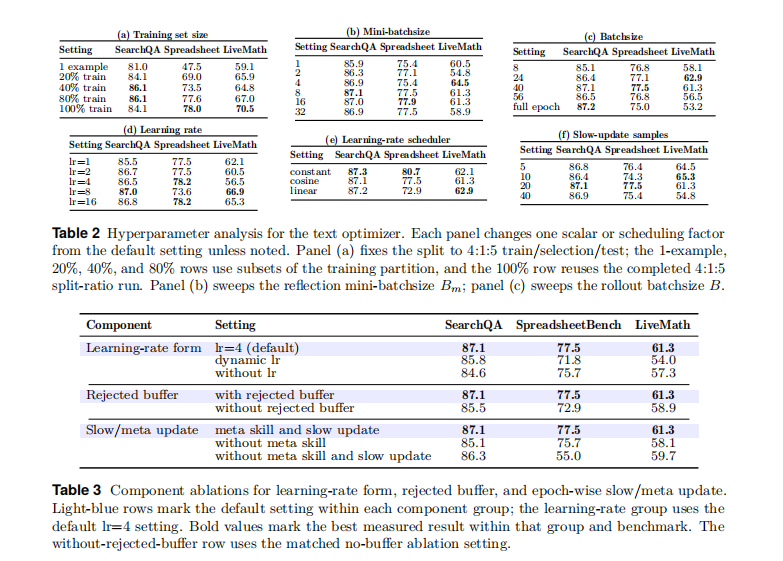
    全面的消融实验有力证明了 SKILLOPT 各组件的关键作用。有界学习率、拒绝编辑缓冲、严格验证门控以及逐纪元慢/元更新共同构成了性能提升的核心。其中,移除慢/元更新在 SpreadsheetBench 上导致了高达 22.5 个百分点的剧烈性能下降,凸显长期跨 epoch 指导对于捕捉持久领域模式的重要性。其他组件的移除同样会带来显著退化,进一步验证了整个优化框架设计的系统性和必要性。

    SkILLOPT: Executive Strategy forSelf-Evolving Agent Skills插图5

    最终学到的技能文档表现出极佳的紧凑性和编辑经济性:长度稳定控制在 300–2000 token 之间,通常仅需 1–4 次接受的编辑即可实现大幅性能提升。这种高效率源于验证门控对低质量提议的严格过滤,大量潜在编辑被拒绝并转化为负反馈,保障了部署技能的高质量。学到的规则高度程序化,聚焦于通用策略而非具体实例,例如要求系统检查工作簿结构、严格绑定视觉证据、维护搜索前沿记忆等。这些规则不仅可读性强、便于人工审计,还体现了接近人类专家水平的洞察力。训练成本分析显示,虽然不同基准的 token 消耗有所差异,但整体可控,且一次性训练后即可长期复用,性价比极高。

    SkILLOPT: Executive Strategy forSelf-Evolving Agent Skills插图6

    5. 结论与展望

    SKILLOPT 为 LLM 代理技能优化提供了首个系统性、可控的文本空间优化框架。它成功证明,通过将技能文档作为外部可训练状态,并应用类似深度学习的控制机制(学习率、验证门控、慢更新等),能够在不修改模型权重的前提下实现显著且稳定的性能提升。该方法在广泛实验中展现的优越性、转移能力和可解释性,为代理系统的实际部署开辟了全新路径。

    展望未来,可进一步扩展至多技能库协同进化、偏好驱动或无奖励验证机制,以及将优化技能自蒸馏回目标模型以实现混合适应等方向。总体而言,SKILLOPT 是一篇具有重要理论创新和强大实践价值的论文,为构建更智能、更可靠的 LLM 代理系统贡献了关键方法论。

  • Astral: A Datacenter Infrastructure for Large Language Model Training at Scale

    Astral: A Datacenter Infrastructure for Large Language Model Training at Scale

    1. 课题背景与系统目标:应对万亿参数训练挑战

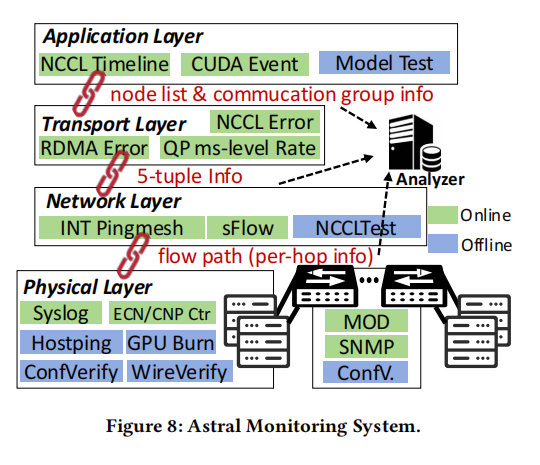
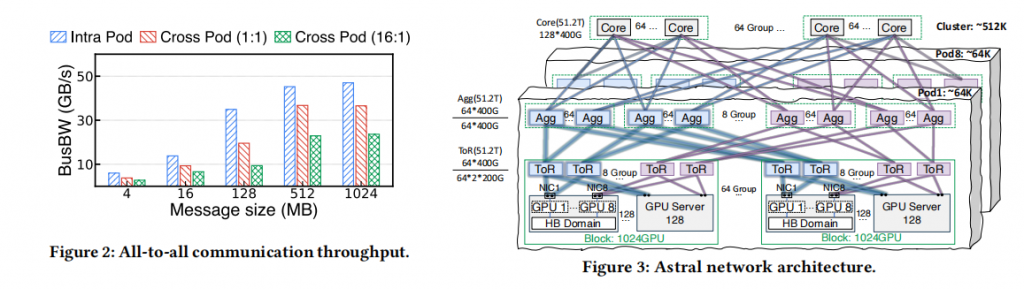
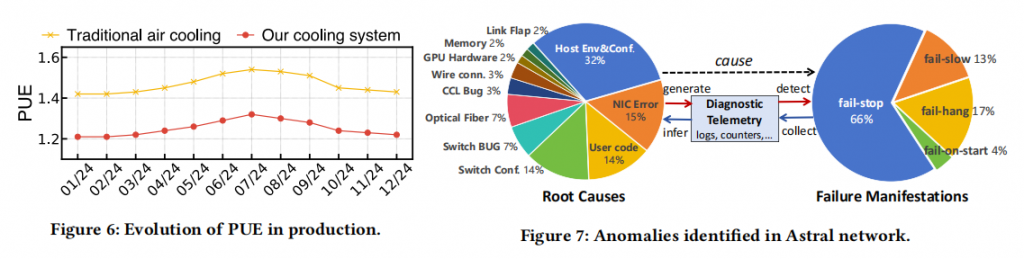
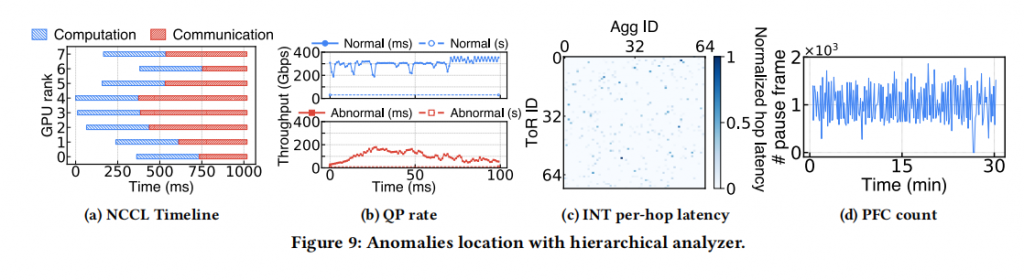
    随着大语言模型(LLM)向万亿级参数演进,底层基础设施面临着前所未有的压力。传统的通用数据中心架构在处理 LLM 训练时存在三个核心瓶颈:首先,高密度的算力需求导致单机柜功耗激增,传统风冷系统难以为继;其次,千卡甚至万卡级别的并行训练对网络拓扑的带宽和延迟极其敏感,任何网络阻塞都会导致算力利用率(MFU)大幅下降;最后,在超大规模集群中,硬件故障、网络抖动和软件异常几乎成为常态,如何从海量的监控数据中快速精准地定位故障根因,是维持训练连续性的关键。

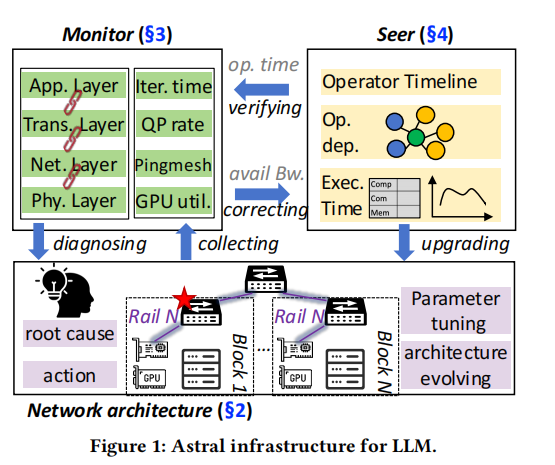
    Astral 系统的设计目标是打造一个“全栈式”的 LLM 专用基础设施。它不仅关注软件层面的优化,更从物理层(供电与散热)、网络层(拓扑架构)以及监控层(自动化运维)进行了深度的垂直整合。通过这些创新,Astral 旨在支持万亿规模模型的稳定、高效训练,将基础设施从“通用计算平台”转型为“AI 专用工厂”。

    2. 物理层创新:高压直流供电与液冷集成方案

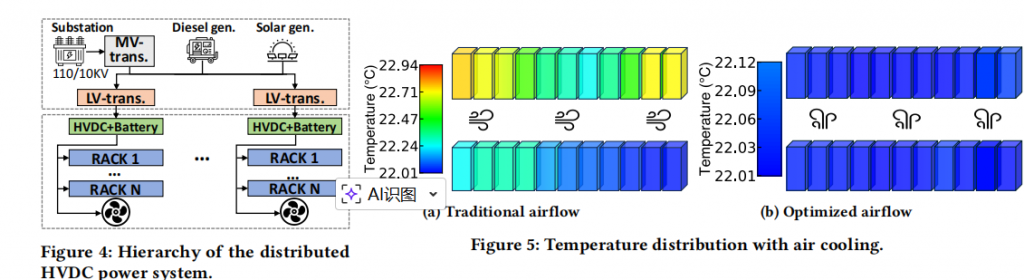
    在物理部署层面,Astral 针对 LLM 集群的高功率密度特性,引入了分布式高压直流(HVDC)供电系统。相比于传统的交流电供电,HVDC 显著减少了电能转换次数,提高了能源利用效率,并为 GPU 服务器提供了更稳定的电力保障。为了支撑单机柜超过 100kW 的功耗,Astral 采用了先进的“风液集成”冷却系统。这种系统利用冷板式液冷直接带走 GPU 和 CPU 的大部分热量,同时辅以精密风冷处理电感、电容等组件的余热,确保了在超高算力密度下的热稳定性。

    这种物理层的变革不仅是硬件的堆叠,更是对机房空间的重构。Astral 的设计使得在有限的机房面积内可以部署更多的算力单元,显著提升了数据中心的算力密度(Compute Density)。同时,液冷系统的引入将数据中心整体的 PUE(能源使用效率)降至极低水平,降低了万亿模型训练的长周期运营成本,为绿色 AI 提供了底层支撑。

    3. 网络层架构:Tier-2 同轨(Same-rail)互联网络

    网络拓扑是 Astral 的核心技术亮点之一。为了消除大规模训练中的 All-to-All 通信瓶颈,Astral 设计了一种创新的 Tier-2 同轨互联架构。在传统的 3D 并行(TP/PP/DP)策略中,由于跨交换机跳数多,同轨通信(Same-rail communication)往往会跨越多个网络层级,导致延迟增加。Astral 通过在 Tier-2 层级建立专门的同轨互联,使得大规模集群中的张量并行(TP)和专家并行(EP)流量能够在最短路径内完成交换。

    这种架构设计的核心价值在于其“可扩展性”。通过优化 Tier-2 的物理连线和逻辑映射,Astral 能够支持从数百卡平滑扩展至数万卡。实验表明,这种同轨设计不仅降低了网络拥塞的风险,还极大地简化了路由策略。结合自研的通信库优化,Astral 能够确保在万卡规模下,网络通信开销不再是制约算力利用率的“木桶短板”。

    Astral: A Datacenter Infrastructure for Large Language Model Training at Scale插图

    4. 监控与运维:跨主机层次化日志关联系统

    在超大规模集群中,“抓取故障”就像大海捞针。Astral 提出了一套全栈监控系统,其核心特征是“跨主机”和“层次化”的日志关联。传统的监控系统往往孤立地查看单机指标(如 CPU/GPU 利用率),而 Astral 则将网络交换机、服务器硬件、操作系统内核、通信库(如 NCCL)以及深度学习框架(如 PyTorch)的日志进行多维聚合。通过全局唯一的 Request ID 或时间戳,运维系统可以回溯一个通信请求在整个集群中的流转路径。

    Astral: A Datacenter Infrastructure for Large Language Model Training at Scale插图1
    Astral: A Datacenter Infrastructure for Large Language Model Training at Scale插图2

    为了实现秒级故障定位,Astral 引入了自动化的故障特征提取引擎。当训练任务因 NCCL Timeout 或 GPU 掉卡而中断时,系统能自动比对异常发生前后的硬件指标变化,并结合拓扑图定位出故障源(如某个光模块损坏或某条链路误码)。这种从“被动响应”到“主动诊断”的转变,将大规模集群的平均修复时间(MTTR)缩短了 80% 以上,极大地提升了科研人员的开发效率。

    Astral: A Datacenter Infrastructure for Large Language Model Training at Scale插图3

    5. 实验分析:Seer 性能预测与实测数据

    Astral 引入了一个关键组件 Seer,用于算子级的执行时间预测。实验数据显示,Seer 在预测算子执行时间轴方面表现出了极高的准确性。通过对比实际运行曲线与 Seer 生成的预测曲线,其平均预测误差控制在 5% 以内。在 3D 并行策略的配置选择上,Seer 能够帮助研究人员在数秒内筛选出最优的 TP/PP/DP 组合,避免了在昂贵真实集群上进行昂贵的“试错法”实验。

    Astral: A Datacenter Infrastructure for Large Language Model Training at Scale插图4

    在实际吞吐量对比中,Astral 的同轨网络架构展现了显著优势。数据显示,在万卡级别的 All-to-All 通信测试中,采用同轨设计的网络带宽利用率比传统架构提升了 25% – 35%。在端到端的 LLM 训练任务(如千亿参数模型)中,Astral 的算力利用率(MFU)稳定在 55% 以上,远高于行业平均水平。此外,全栈监控系统在 6 个月的运行周期内,成功预警并定位了超过 95% 的硬件软故障,保障了训练任务的超长周期连续运行。

    Astral: A Datacenter Infrastructure for Large Language Model Training at Scale插图5
    Astral: A Datacenter Infrastructure for Large Language Model Training at Scale插图6
    Astral: A Datacenter Infrastructure for Large Language Model Training at Scale插图7

    6. 结论与工业洞察:从基础设施到算力生态

    Astral 的研究报告为未来的 AI 基础设施建设提供了宝贵的蓝图。它证明了在 LLM 时代,基础设施不再是离散的硬件组合,而是一个需要从电力、冷却、网络到软件监控进行全链路联动的整体。Astral 的成功在于其深刻理解了“通信驱动算力”的本质,通过同轨网络解决了扩展性难题,通过 HVDC 和液冷解决了能耗难题,通过 Seer 和层次化日志解决了运维难题。

    对于行业而言,Astral 的实践启示我们:未来的超算中心必须是“应用感知”的。只有当底层设施能够深刻理解大模型并行计算的流量模式和资源需求时,才能真正实现算力的最优释放。随着模型规模向 10 万亿参数迈进,Astral 所倡导的这种全栈协同设计理念,将成为构建下一代 AI 数据中心的基础准则。

  • MegaScale-Infer: Efficient Mixture-of-Experts Model Serving with Disaggregated Expert Parallelism

    MegaScale-Infer: Efficient Mixture-of-Experts Model Serving with Disaggregated Expert Parallelism

    SIGCOMM 2025

    1. 研究背景与核心痛点:MoE 推理的效率瓶颈

    随着大语言模型进入“万亿参数时代”,混合专家模型(Mixture-of-Experts, MoE)因其能在增加参数量的同时保持较低的激活计算量,成为了构建超大规模模型的首选架构。然而,在实际推理场景中,MoE 模型面临着严峻的挑战。传统的推理系统通常将注意力机制(Attention)和全连接层(FFN/Experts)绑定在同一块 GPU 上处理,这种“耦合架构”导致了严重的资源错配:Attention 模块通常是计算密集型的,而 MoE 中的专家层(FFN)由于其稀疏激活的特性,转变为显存带宽密集型(Memory-bound),导致 GPU 利用率低下,运营成本高昂。

    此外,MoE 模型的专家并行(Expert Parallelism)在大规模部署时会产生巨大的全开销通信(All-to-All communication)。在传统的耦合并行策略下,这种通信开销往往与计算重叠不足,进一步拉长了推理延迟。对于像 DeepSeek-V3 这样拥有数百个专家的模型,如何在保证吞吐量的同时降低延迟,并解决专家负载不均(Expert Unbalance)带来的长尾效应,是当前分布式推理领域亟待解决的底层难题。

    MegaScale-Infer: Efficient Mixture-of-Experts Model Serving with Disaggregated Expert Parallelism插图
    MegaScale-Infer: Efficient Mixture-of-Experts Model Serving with Disaggregated Expert Parallelism插图1

    2. 核心创新:专家并行与注意力机制的解耦(Disaggregation)

    MegaScale-Infer 提出了一个革命性的系统框架,其核心思想是“注意力与专家的解耦部署”。该系统将模型每一层中的 Attention 模块和 FFN 专家模块剥离,分别部署在不同的 GPU 资源池中。这种设计允许针对两类模块的不同特性进行独立缩放:Attention 池可以配置计算能力更强的硬件并采用张量并行(Tensor Parallelism),而专家池则可以部署在显存容量大、带宽高的硬件上,采用更大规模的专家并行(EP)。通过这种异构部署,系统能够实现计算资源与模型需求的精准匹配。

    MegaScale-Infer: Efficient Mixture-of-Experts Model Serving with Disaggregated Expert Parallelism插图2

    为了解决解耦带来的模块间通信压力,MegaScale-Infer 引入了“乒乓流水线并行”(Ping-Pong Pipeline Parallelism)。系统将一个请求批次(Batch)划分为多个微批次(Micro-batches),并在 Attention 池和专家池之间进行穿梭式推理。当第一组微批次在专家池进行专家计算时,第二组微批次可以在 Attention 池进行预处理。这种设计极大地重叠了跨池通信与内部计算的时间,确保了流水线的高效运转。同时,针对 MoE 的稀疏性,系统设计了动态调度机制,确保请求能够实时分发到空闲的专家实例上。

    MegaScale-Infer: Efficient Mixture-of-Experts Model Serving with Disaggregated Expert Parallelism插图3

    3. 系统优化:动态负载均衡与通信隐藏

    在解耦架构的基础上,MegaScale-Infer 进一步针对专家负载不均衡问题进行了深度优化。在 MoE 推理中,某些“热门专家”可能会被频繁调用,而其他专家则相对闲置。系统通过引入“专家副本(Expert Replication)”和“动态负载感知调度”技术,能够根据实时流量自动调整不同专家的副本数量。这意味着系统可以动态地在专家池中重分配资源,将负载压力从过热节点转移到空闲节点,从而显著降低了推理的长尾延迟(Tail Latency)。

    MegaScale-Infer: Efficient Mixture-of-Experts Model Serving with Disaggregated Expert Parallelism插图4

    在通信层面,MegaScale-Infer 对 All-to-All 算子进行了定制化改造。它利用解耦架构下的网络拓扑特性,优化了跨节点的数据交换路径。通过与字节跳动内部大规模生产环境的结合,系统能够利用高速 RDMA 网络,实现计算、显存拷贝与网络传输的三重重叠。这种深度的工程优化使得系统在处理超大 Batch Size 时,依然能保持线性增长的吞吐能力,避免了传统 EP 并行中常见的通信崩塌现象。

    4. 实验结论与学术意义

    实验结果显示,在部署 DeepSeek 或 Switch Transformer 等大规模 MoE 模型时,MegaScale-Infer 相比于传统的 vLLM 或 DeepSpeed-Inference 方案,实现了 1.5x 到 3.2x 的吞吐量提升,同时显著降低了单位请求的成本。在端到端的生产环境测试中,该系统展现了极强的扩展性,能够平滑支撑从数十个到数千个 GPU 的推理集群规模。特别是在异构硬件环境下,解耦架构的灵活性得到了充分验证,证明了混合使用高性能计算显卡与高带宽显存显卡的可行性。

    MegaScale-Infer: Efficient Mixture-of-Experts Model Serving with Disaggregated Expert Parallelism插图5
    MegaScale-Infer: Efficient Mixture-of-Experts Model Serving with Disaggregated Expert Parallelism插图6
    MegaScale-Infer: Efficient Mixture-of-Experts Model Serving with Disaggregated Expert Parallelism插图7
    MegaScale-Infer: Efficient Mixture-of-Experts Model Serving with Disaggregated Expert Parallelism插图8

    结论与启示:MegaScale-Infer 的成功标志着分布式推理系统正从“通用并行”向“架构感知并行”演进。它通过解耦这一手段,打破了单一 GPU 内部的资源约束瓶颈。对于研究人员而言,这篇论文提供了处理稀疏激活模型的新思路——即不仅要优化算法层面的稀疏性,更要从系统架构层面去适配这种稀疏性。未来的研究可以进一步探索如何在解耦环境下进行自动化的模型切分与资源编排,以及如何将该架构推广到多模态大模型的长序列推理中。